Cloudflare und KI-Bots: die Einstellung, die Googlebot unbemerkt aussperren kann
 Von Thierry Gustin
Aktualisiert am
6 Min. Lesezeit
Inhalt
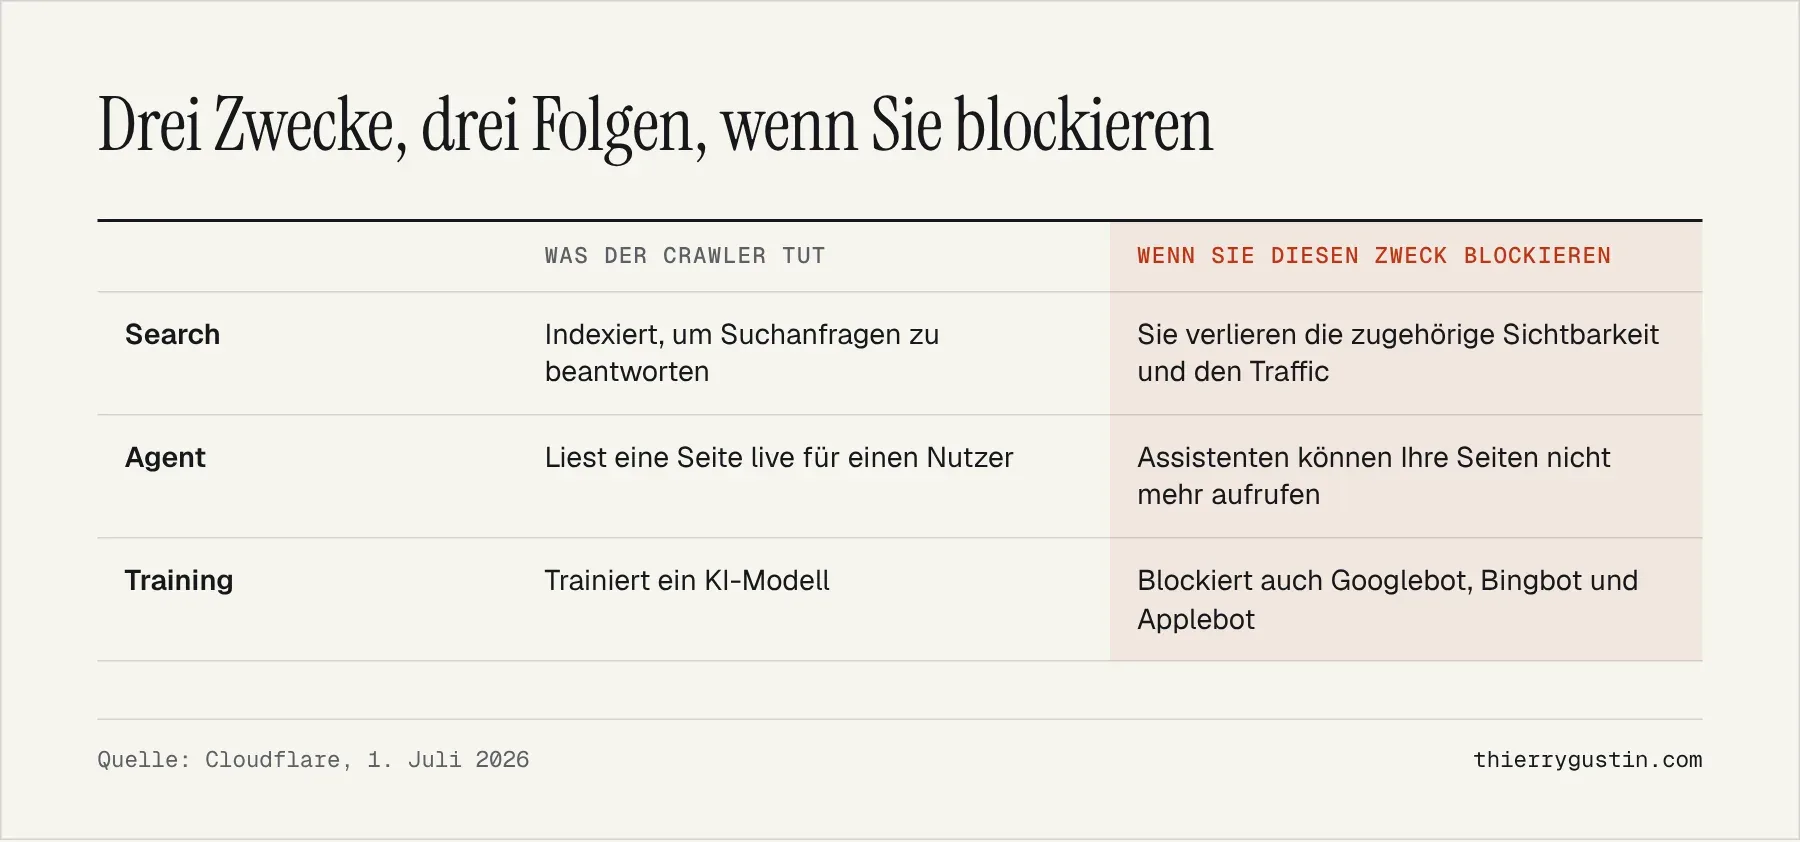
Seit dem 1. Juli 2026 können alle Cloudflare-Kunden, auch im kostenlosen Tarif, KI-Crawler blockieren, und zwar getrennt nach drei Zwecken: Suche, Agent und Training[1]. Genau hier liegt die Falle: Wer Training blockiert, bei dem sperrt Cloudflare auch Mehrzweck-Crawler wie Googlebot, Bingbot und Applebot aus, die sowohl der Suche als auch der KI dienen. Eine Einstellung, die Ihre Inhalte schützen soll, kann Sie also aus Google entfernen.
Das betrifft viele KMU, in Frankreich ebenso wie in Spanien: Cloudflare wird oft vom Hoster oder von der Agentur beim Livegang aktiviert, und danach schaut niemand mehr in die Einstellungen. Mit dem Abstand von November 2026, und weil seit dem 15. September neue Standardeinstellungen gelten, gehört dieser Punkt zu den ersten, die ich bei einem Audit prüfe.
Was hat Cloudflare am 1. Juli 2026 geändert?
Zum zweiten „Content Independence Day“ hat Cloudflare die Bot-Verwaltung um drei Zwecke herum neu geordnet[1]. Search: Der Crawler baut einen Index auf, um später Suchanfragen zu beantworten, und die Website kann im Gegenzug Traffic erwarten. Agent: Der Crawler handelt in Echtzeit im Auftrag einer Person, etwa wie ein Assistent, der während eines Gesprächs eine Seite liest. Training: Der Inhalt dient zum Trainieren eines Modells und bleibt dauerhaft darin aufgenommen.
Die zweite, unauffälligere Änderung: Ein „verifizierter“ Bot ist nicht mehr automatisch standardmäßig zugelassen. Cloudflare schreibt, dass es „Verified“ nicht mehr als „default allowed“ behandelt: Ein verifizierter Bot wird nun je nach der Kategorie, in die er fällt, zugelassen oder nicht[1].
Die dritte Änderung ist die problematische: Crawler, die Suche und Training vermischen, werden nach der Gesamtheit ihrer Zwecke beurteilt, und es gilt die restriktivste Regel. Cloudflare sagt es unverblümt: Googlebot, Applebot und Bingbot „will be blocked by customers who have selected to block Training“[1].
Warum kann das Blockieren von Training Googlebot aussperren?
Weil Google für die Suche und für seine KI-Produkte dieselben Crawler verwendet. Die Dokumentation erklärt es: Das Token Google-Extended, mit dem Sie die Nutzung Ihrer Inhalte für das Training künftiger Gemini-Modelle ablehnen können, hat keinen eigenen User-Agent; gecrawlt wird mit den üblichen Google-Crawlern[2]. Aus Sicht von Cloudflare erfüllt Googlebot also sowohl das Kriterium Suche als auch das Kriterium Training.
Der Unterschied ist entscheidend. Training über Google-Extended in Ihrer robots.txt abzulehnen, hat keine Auswirkung auf die Suche: Google stellt klar, dass dieses Token „does not impact a site's inclusion in Google Search“ und kein Ranking-Signal ist[2]. Googlebot dagegen auf Firewall-Ebene zu blockieren, hindert ihn daran, Ihre Seiten zu lesen – mit den absehbaren Folgen für die Indexierung.
Cloudflare schlägt außerdem vor, die robots.txt um ein Präferenzsignal zu ergänzen, derzeit im Test, etwa „Content-Signal: search=yes,ai-train=no,use=reference“[1]. Cloudflare betont selbst, dass diese Werte eine Präferenz ausdrücken und nichts blockieren: Kein Crawler ist verpflichtet, sie zu beachten. Ich würde mich weder zum Schutz von Inhalten noch für das Verhältnis zu Google darauf verlassen.
Was ändern die Standardeinstellungen vom 15. September 2026?
Seit dem 15. September 2026 erhalten neue Domains bei Cloudflare strengere Standardeinstellungen: Auf Seiten, die Werbung anzeigen, sind Trainings-Crawler und Agenten blockiert, die Suche bleibt erlaubt[1]. Bestandskunden konnten dies vor diesem Datum in ihren Sicherheitseinstellungen abwählen.
Für ein KMU verdienen zwei Situationen eine Prüfung. Wurde Ihre Website nach dem 15. September zu Cloudflare migriert oder dort neu aufgesetzt und zeigt sie Werbung, können KI-Agenten (die eine Seite während eines Gesprächs lesen) blockiert sein, ohne dass jemand das entschieden hat. Und hat jemand in bester Absicht „Training blockieren“ angehakt, kann Googlebot betroffen sein, unabhängig vom Alter der Domain.
Fallen KI-Crawler wirklich so stark ins Gewicht?
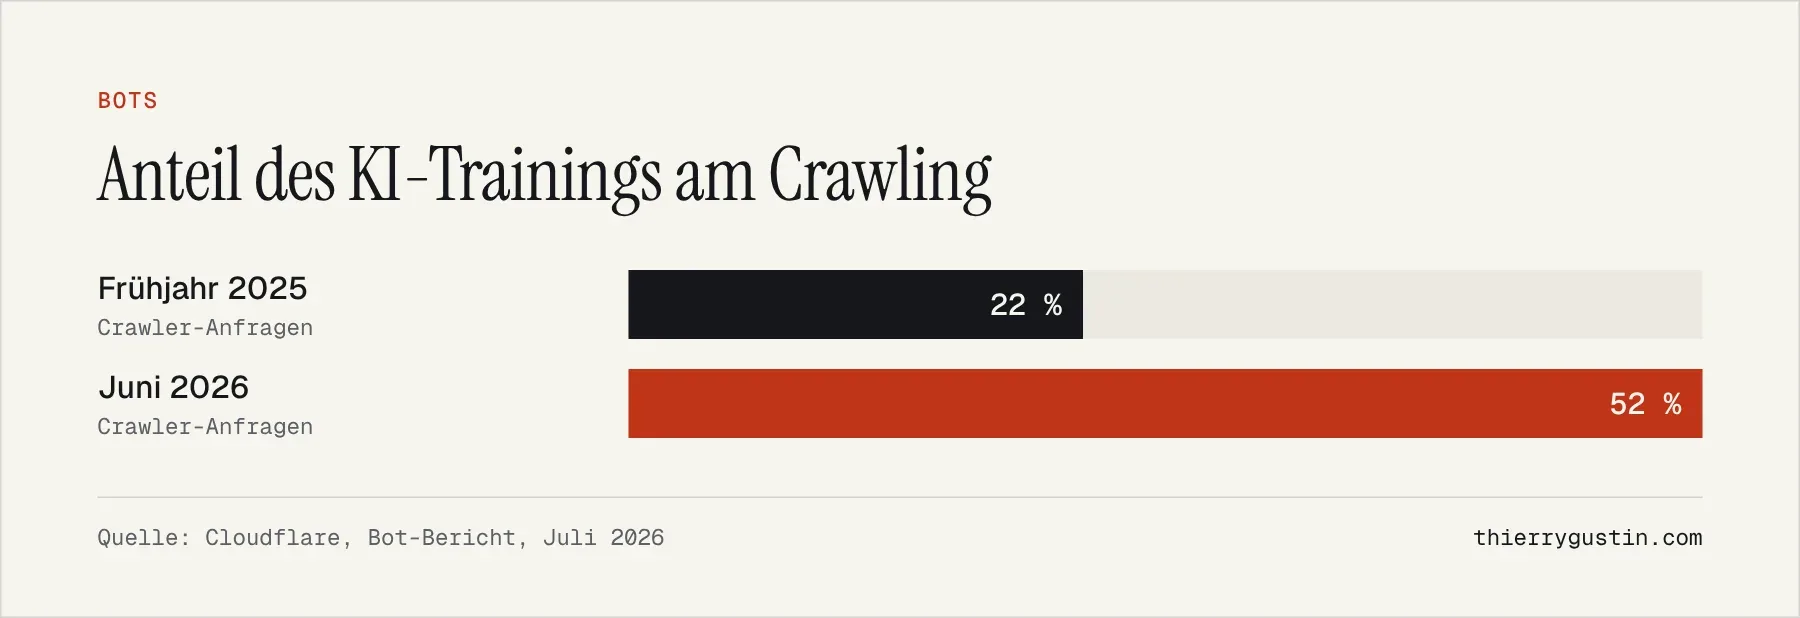
Ja, und das erklärt die Reaktion von Cloudflare. Laut seinem Bot-Bericht machte KI-Training im Juni 2026 52 % der Crawler-Anfragen aus, gegenüber 22 % im Frühjahr 2025. Mehr als die Hälfte des Internet-Traffics ist nicht mehr menschlich[3].
Demgegenüber bleibt der zurückgeschickte Traffic konzentriert: Google steht für rund 88 % des von Cloudflare beobachteten Referral-Traffics[3]. Anders gesagt: Die meisten Crawler crawlen, um zu trainieren, und der Großteil der Besuche kommt weiterhin von einer einzigen Suchmaschine. Genau deshalb muss man gezielt blockieren, und niemals auf Kosten von Googlebot.
Cloudflare testet zudem ein Modell „Pay Per Use“, eine Weiterentwicklung seines Bezahlens pro Crawl, mit Ceramic.ai und You.com, und räumt ein, dass es sich um ein Experiment handelt[4]. Für ein KMU ist das etwas zum Beobachten, nicht für den Businessplan.
Meine Einschätzung
Die Absicht von Cloudflare ist legitim: Websites eine einfache Möglichkeit zu geben, abzulehnen, dass ihre Inhalte ohne Gegenleistung Modelle füttern. Aber die Entscheidung, Mehrzweck-Crawler zu blockieren, sobald man Training ablehnt, macht aus einer Grundsatzeinstellung ein geschäftliches Risiko. Nur wenige KMU-Chefs wissen, dass ein Häkchen bei „KI“ sie von Google abschneiden kann.
Meine Haltung gegenüber Kunden ist einfach. Für ein Unternehmen, das Dienstleistungen oder Produkte verkauft, ist es ein Vorteil, von Suchmaschinen und Assistenten gelesen zu werden: Nur so wird man in einer Antwort von Google, ChatGPT oder Claude zitiert. Ich rate, Search und Agent offen zu lassen und die Trainingsfrage in der robots.txt zu regeln, Crawler für Crawler, statt an der Firewall.
Anders liegt der Fall bei Anbietern, deren Inhalt das Produkt ist (Presse, kostenpflichtige Studien, Schulungen); für sie ist es diskutabel, Training zu blockieren. Aber selbst dann ziehe ich Google-Extended und die Opt-out-Einstellung der Search Console, die seit dem 31. August 2026 allen Websites offensteht[5], einer pauschalen Sperre von Googlebot vor. Diese beiden Hebel trennen Suche und KI sauber voneinander.
Was sollten Sie konkret tun?
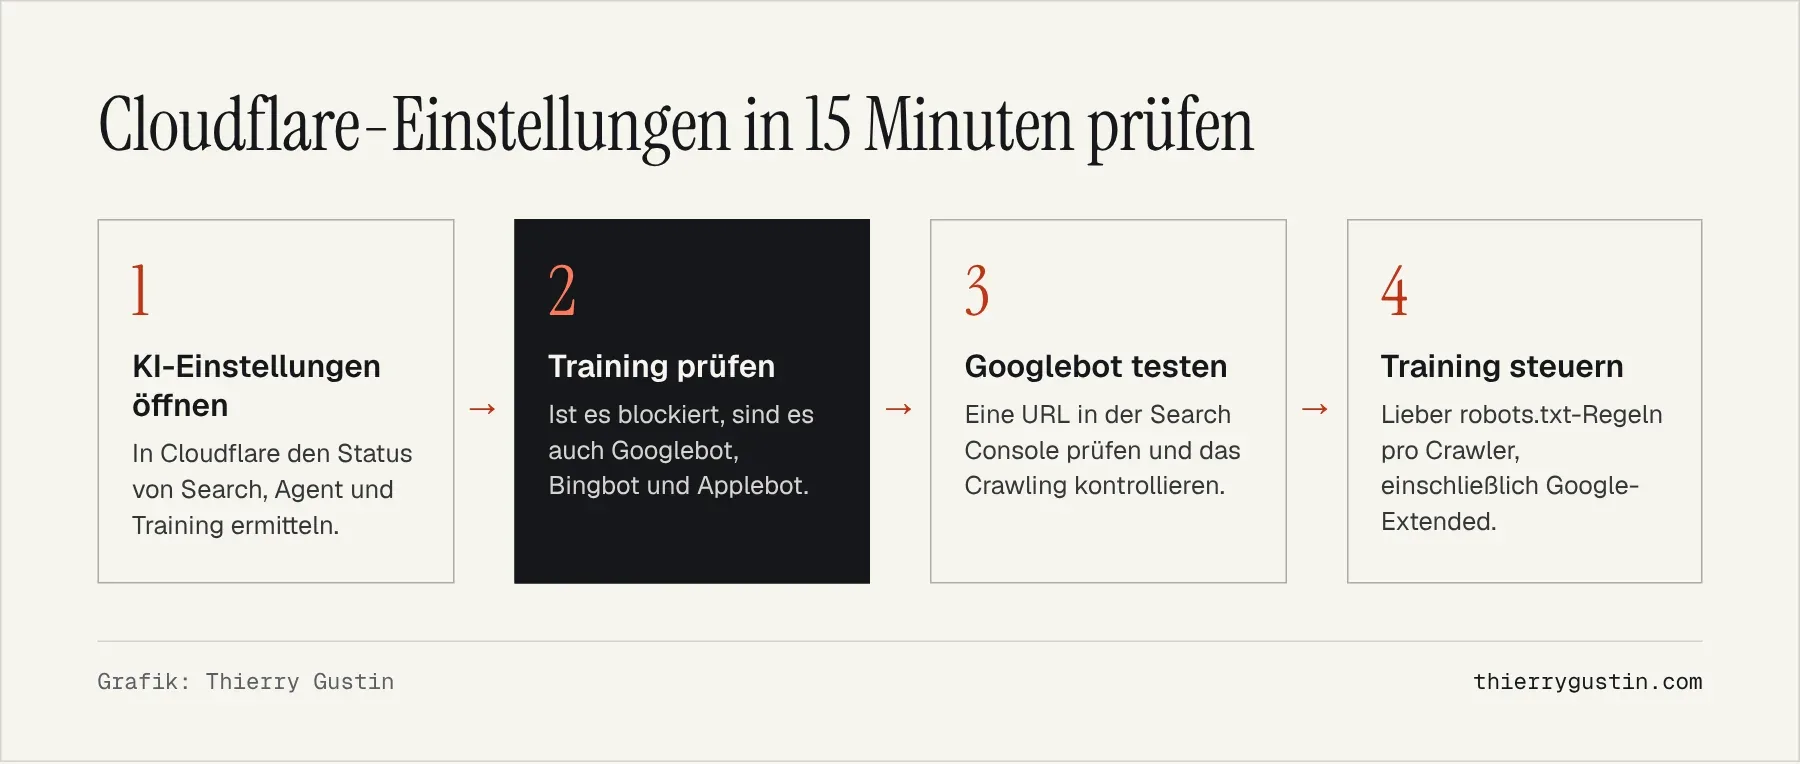
Machen Sie eine Bestandsaufnahme. Fragen Sie Ihren Hoster oder Ihre Agentur, ob die Website über Cloudflare läuft und wer Zugriff darauf hat. Viele KMU stellen dabei fest, dass kein Mitarbeiter die Zugangsdaten besitzt.
Testen Sie mit Google selbst. Das URL-Prüftool der Search Console zeigt, ob Googlebot eine Seite kürzlich crawlen konnte. Ein plötzlicher Crawling-Fehler ohne Änderung an der Website sollte Sie an die Firewall denken lassen.
Halten Sie Ihre Regeln in der robots.txt fest. Sie ist der einzige Ort, den alle lesen können, und die Methode, die ich im Crawler-Abschnitt des GEO-Leitfadens beschreibe. Um anschließend zu prüfen, was ein Crawler tatsächlich abruft, durchläuft der Open-Source-Crawler Arachnide Ihre Website so, wie es eine Suchmaschine tun würde. Eine llms.txt-Datei für Google brauchen Sie dagegen nicht: Google hat im Juni klargestellt, dass es keine benötigt[6].
Häufige Fragen
Kann das Blockieren von KI-Crawlern in Cloudflare meinem Google-Ranking schaden?
Ja, wenn Sie die Kategorie Training blockieren. Seit dem 1. Juli 2026 wendet Cloudflare auf Mehrzweck-Crawler die restriktivste Regel an: Googlebot, Bingbot und Applebot werden bei Kunden blockiert, die Training ablehnen. Googlebot kann Ihre Seiten dann nicht mehr crawlen, was ihre Indexierung und ihr Ranking gefährdet.
Wie lehne ich das Gemini-Training ab, ohne Googlebot zu blockieren?
Fügen Sie in Ihrer robots.txt eine Regel für das Token Google-Extended hinzu. Laut Google steuert dieses Token die Nutzung von Inhalten für das Training der Gemini-Modelle, ohne Auswirkung auf die Aufnahme in die Suche oder auf das Ranking. Das ist feiner als eine Firewall-Sperre, die die Zwecke eines einzelnen Crawlers nicht unterscheidet.
Was haben die Cloudflare-Einstellungen vom 15. September 2026 geändert?
Bei neuen Domains, die ab dem 15. September 2026 zu Cloudflare hinzugefügt werden, sind KI-Trainings-Crawler und KI-Agenten auf Seiten mit Werbung standardmäßig blockiert. Such-Crawler bleiben erlaubt. Bestandskunden konnten dies vor diesem Datum in ihren Sicherheitseinstellungen abwählen.
Sollte ich KI-Agenten wie die von ChatGPT oder Claude blockieren?
Für die meisten KMU nicht. Agenten lesen eine Seite live, um einem Nutzer zu antworten, oft mit einem Link zur Quelle. Wer sie blockiert, verzichtet darauf, genau in dem Moment aufgerufen und zitiert zu werden, in dem ein potenzieller Kunde seine Frage stellt. Eine Sperre ist vor allem bei kostenpflichtigen Inhalten gerechtfertigt.
Quellen
- Cloudflare, Content Independence Day: Optionen Search, Agent und Training (1. Juli 2026, aktualisiert am 15. Juli)
- Google Search Central, gängige Google-Crawler und das Token Google-Extended
- Cloudflare, Bericht über Bots und das agentische Internet (1. Juli 2026)
- Cloudflare, „Making AI search smarter“, von Pay Per Crawl zu Pay Per Use (1. Juli 2026)
- Google, neue Kontrolle für Funktionen mit generativer KI in der Search Console (3. Juni 2026, aktualisiert am 31. August 2026)
- Google Search Central, Änderungsprotokoll der Dokumentation (Eintrag vom 15. Juni 2026 zu llms.txt)