Cloudflare e os bots de IA: a configuração que pode barrar o Googlebot sem aviso
 Por Thierry Gustin
Atualizado em
7 min de leitura
Índice
Desde 1º de julho de 2026, a Cloudflare dá a todos os seus clientes, inclusive no plano gratuito, a opção de bloquear bots de IA conforme três usos: busca, agente e treinamento[1]. A armadilha está aí: se você bloquear o treinamento, a Cloudflare também bloqueia os rastreadores polivalentes, como o Googlebot, o Bingbot e o Applebot, que servem ao mesmo tempo para a busca e para a IA. Uma configuração pensada para proteger os seus conteúdos pode, portanto, tirar você do Google.
O assunto afeta muitas pequenas empresas, na França e na Espanha: a Cloudflare costuma ser ativada pela hospedagem ou pela agência no momento em que o site vai ao ar, e depois ninguém mais olha as configurações. Com o distanciamento de novembro de 2026, e com novos padrões em vigor desde 15 de setembro, esse é um dos primeiros pontos que verifico em uma auditoria.
O que a Cloudflare mudou em 1º de julho de 2026?
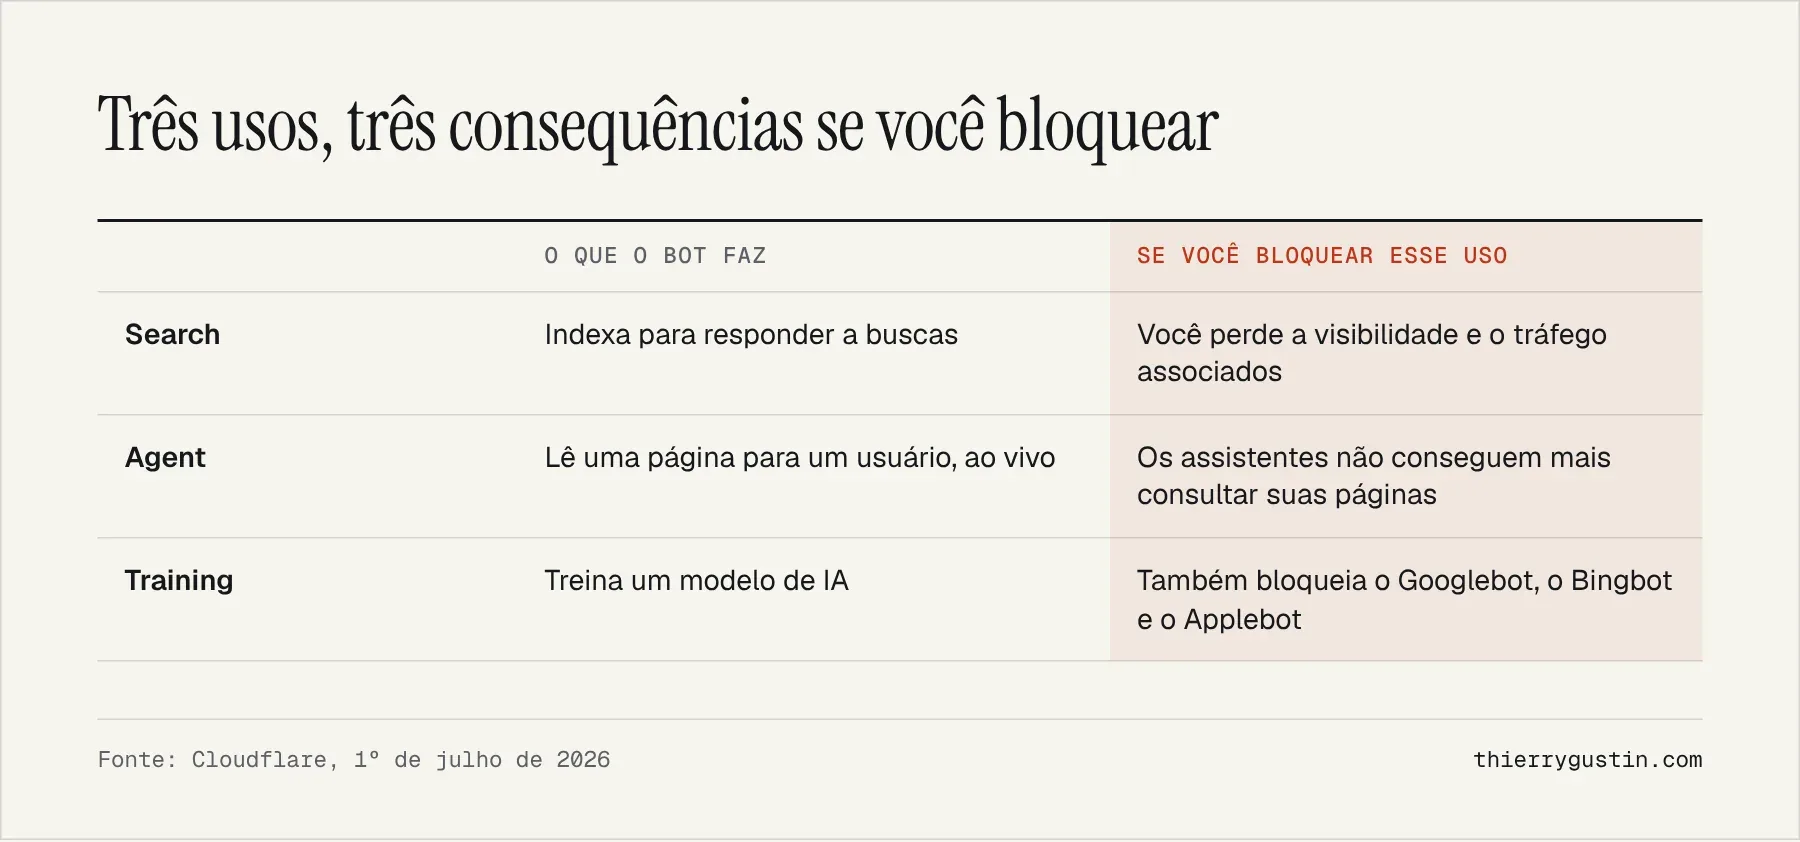
No seu segundo “Content Independence Day”, a Cloudflare reorganizou a gestão dos bots em torno de três usos[1]. Search: o bot constrói um índice para responder depois a buscas, e o site pode esperar tráfego em troca. Agent: o bot age em tempo real em nome de uma pessoa, como um assistente que vai ler uma página durante uma conversa. Training: o conteúdo serve para treinar um modelo e fica absorvido nele para sempre.
Segunda mudança, mais discreta: ser um bot “verificado” não significa mais ser permitido por padrão. A Cloudflare escreve que não considera mais “Verified” como “default allowed”: um bot verificado passa a ser permitido ou não conforme a categoria em que se encaixa[1].
Terceira mudança, a que causa problema: os bots que misturam busca e treinamento são avaliados pelo conjunto dos seus usos, e vale a regra mais restritiva. A Cloudflare diz isso sem rodeios: o Googlebot, o Applebot e o Bingbot “will be blocked by customers who have selected to block Training”[1].
Por que bloquear o treinamento pode bloquear o Googlebot?
Porque o Google usa os mesmos rastreadores para a busca e para os seus produtos de IA. A documentação dele explica: o token Google-Extended, que permite recusar o uso dos seus conteúdos para treinar os futuros modelos Gemini, não tem um user agent próprio; o rastreamento é feito pelos rastreadores habituais do Google[2]. Do ponto de vista da Cloudflare, o Googlebot marca ao mesmo tempo a caixa de busca e a de treinamento.
A diferença é essencial. Recusar o treinamento via Google-Extended no seu robots.txt não tem efeito nenhum na busca: o Google esclarece que esse token “does not impact a site's inclusion in Google Search” e não é um sinal de ranking[2]. Já bloquear o Googlebot no firewall impede que ele leia as suas páginas, com as consequências que dá para imaginar na indexação.
A Cloudflare também propõe complementar o robots.txt com um sinal de preferência, em teste, do tipo “Content-Signal: search=yes,ai-train=no,use=reference”[1]. A própria Cloudflare esclarece que esses valores expressam uma preferência e não bloqueiam nada: nenhum bot é obrigado a respeitá-los. Eu não contaria com eles para proteger o que quer que seja, nem para resolver a relação com o Google.
O que mudam os padrões de 15 de setembro de 2026?
Desde 15 de setembro de 2026, os domínios novos adicionados à Cloudflare recebem configurações padrão mais rígidas: nas páginas que exibem publicidade, os bots de treinamento e os agentes são bloqueados, enquanto a busca continua permitida[1]. Os clientes existentes podiam optar por não aderir nas configurações de segurança antes dessa data.
Para uma pequena empresa, duas situações merecem verificação. Se o seu site foi migrado ou recriado na Cloudflare depois de 15 de setembro e exibe publicidade, os agentes de IA (aqueles que leem uma página durante uma conversa) podem estar bloqueados sem que ninguém tenha decidido isso. E se alguém marcou “bloquear o treinamento” com a melhor das intenções, o Googlebot pode ser afetado, seja qual for a idade do domínio.
Os bots de IA pesam tanto assim?
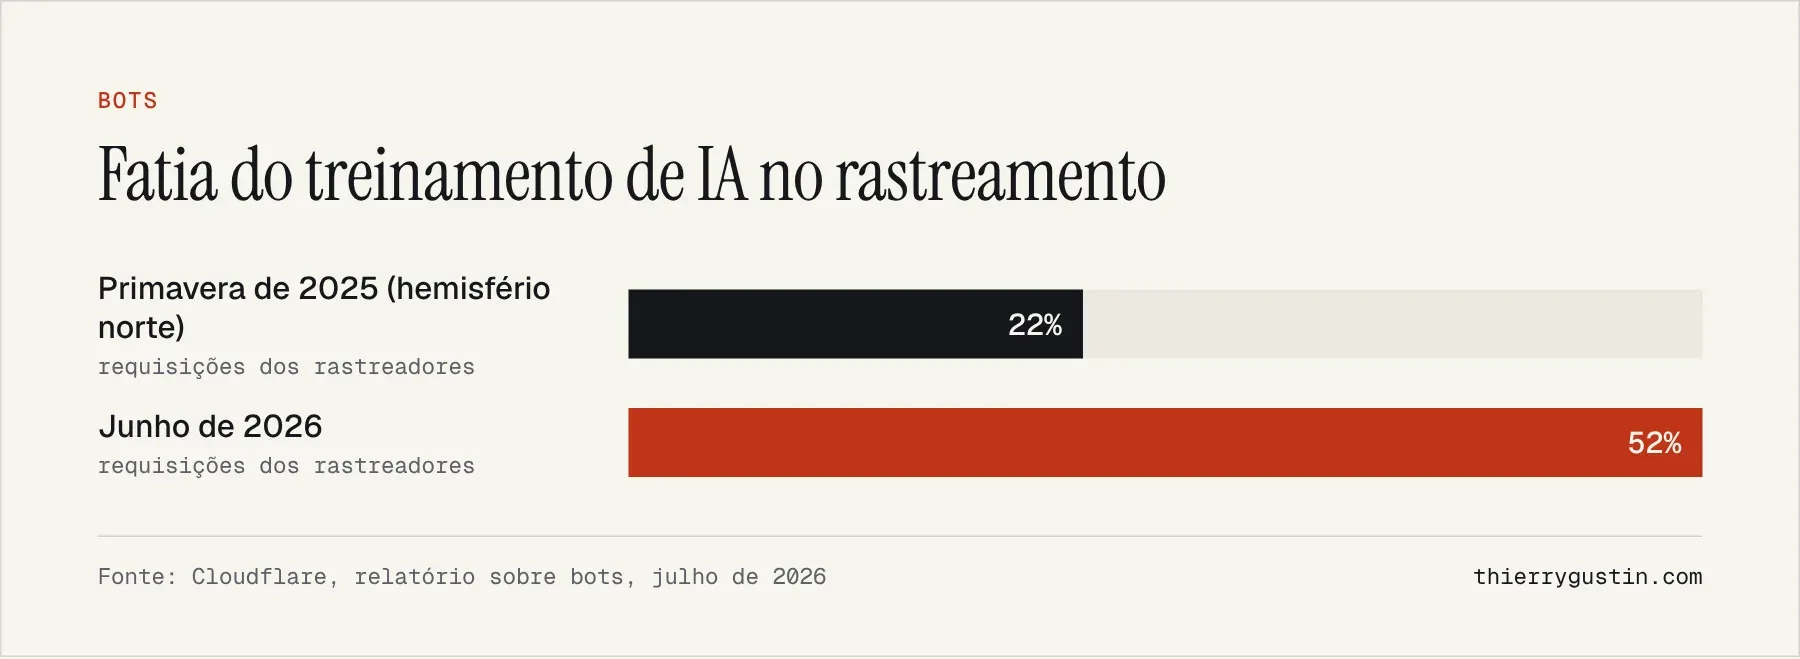
Sim, e é isso que explica a reação da Cloudflare. Segundo o seu relatório sobre bots, o treinamento de IA representava 52% das requisições dos rastreadores em junho de 2026, contra 22% na primavera de 2025 no hemisfério norte. Mais da metade do tráfego da internet já não é humano[3].
Do outro lado, o tráfego devolvido continua concentrado: o Google representa cerca de 88% do tráfego de referência observado pela Cloudflare[3]. Em outras palavras, a maioria dos bots rastreia para treinar, e quase todas as visitas continuam vindo de um único buscador. É exatamente por isso que é preciso bloquear com precisão, e nunca à custa do Googlebot.
A Cloudflare também testa um modelo “Pay Per Use”, evolução do seu pagamento por rastreamento, com a Ceramic.ai e o You.com, reconhecendo que se trata de um experimento[4]. Para uma pequena empresa, é algo para acompanhar, não para incluir em um plano de negócios.
O que eu penso
A intenção da Cloudflare é legítima: dar aos sites uma forma simples de recusar que seus conteúdos alimentem modelos sem contrapartida. Mas a decisão de bloquear os bots polivalentes quando se recusa o treinamento transforma uma configuração de princípio em risco comercial. Poucos donos de pequenas empresas sabem que marcar uma caixinha de “IA” pode tirar o site do Google.
Minha posição com os clientes é simples. Para uma empresa que vende serviços ou produtos, ser lida pelos buscadores e pelos assistentes é um ativo: é isso que permite ser citada em uma resposta do Google, do ChatGPT ou do Claude. Recomendo deixar Search e Agent abertos e tratar a questão do treinamento no robots.txt, bot por bot, em vez de no firewall.
O caso dos publishers cujo conteúdo é o produto (imprensa, estudos pagos, cursos) é diferente; para eles, bloquear o treinamento é uma discussão válida. Mas, mesmo nesse caso, prefiro o Google-Extended e a opção de exclusão do Search Console, aberta a todos os sites desde 31 de agosto de 2026[5], a um bloqueio indiscriminado do Googlebot. Essas duas alavancas separam claramente a busca da IA.
O que fazer na prática?
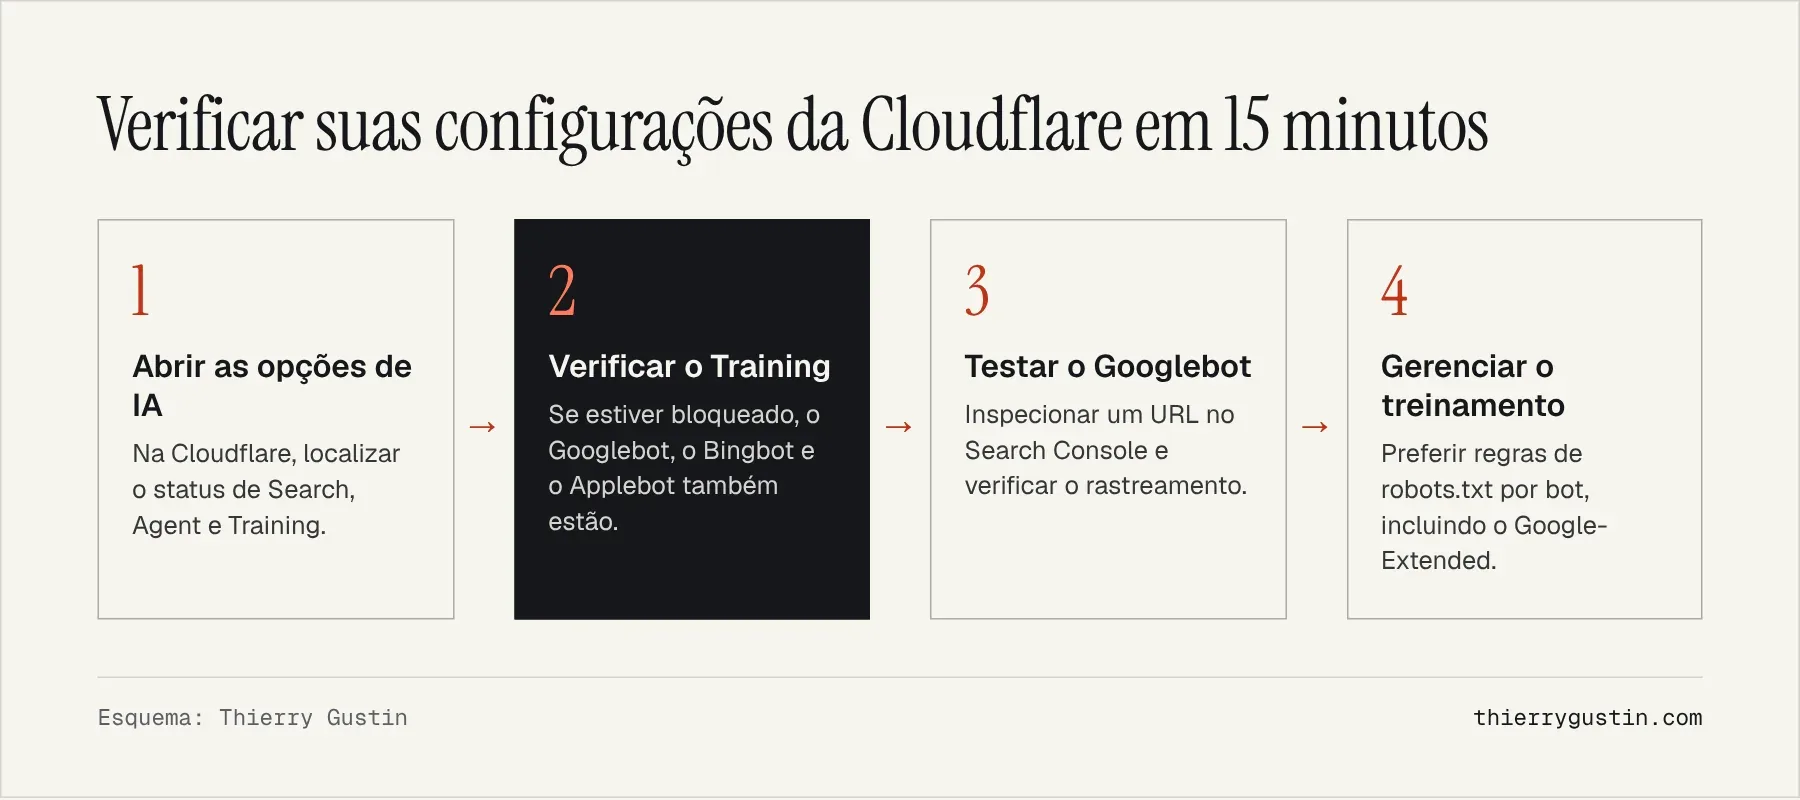
Faça um inventário. Pergunte à sua hospedagem ou à sua agência se o site passa pela Cloudflare e quem tem acesso. Muitas pequenas empresas descobrem nessa hora que nenhum funcionário tem as credenciais.
Teste com o próprio Google. A ferramenta de inspeção de URL do Search Console mostra se o Googlebot conseguiu rastrear uma página recentemente. Uma falha de rastreamento repentina, sem nenhuma alteração no site, deve fazer você pensar no firewall.
Escreva a sua política no robots.txt. É o único lugar que todos conseguem ler, e o método que detalho na seção bots do guia de GEO. Para conferir depois o que um bot coleta, o rastreador open source Arachnide percorre o seu site como faria um buscador. Por outro lado, não adianta adicionar um arquivo llms.txt para o Google: ele esclareceu em junho que não precisa dele[6].
Perguntas frequentes
Bloquear bots de IA na Cloudflare pode prejudicar meu SEO no Google?
Sim, se você bloquear a categoria Training. Desde 1º de julho de 2026, a Cloudflare aplica a regra mais restritiva aos bots polivalentes: o Googlebot, o Bingbot e o Applebot são bloqueados nos clientes que recusam o treinamento. O Googlebot deixa de conseguir rastrear suas páginas, o que ameaça a indexação e o ranking delas.
Como impedir o treinamento do Gemini sem bloquear o Googlebot?
Adicione uma regra para o token Google-Extended no seu robots.txt. O Google informa que esse token controla o uso dos conteúdos para treinar os modelos Gemini, sem efeito na inclusão na busca nem no ranking. É mais preciso do que um bloqueio no firewall, que não distingue os usos de um mesmo bot.
O que mudou nas configurações da Cloudflare em 15 de setembro de 2026?
Para os domínios novos adicionados à Cloudflare a partir de 15 de setembro de 2026, os bots de treinamento e os agentes de IA são bloqueados por padrão nas páginas que exibem publicidade. Os bots de busca continuam permitidos. Os clientes existentes podiam optar por não aderir antes dessa data nas configurações de segurança.
Devo bloquear os agentes de IA, como os do ChatGPT ou do Claude?
Para a maioria das pequenas empresas, não. Os agentes leem uma página ao vivo para responder a um usuário, muitas vezes com um link para a fonte. Bloqueá-los é abrir mão de ser consultado e citado no momento em que um cliente em potencial faz a pergunta. O bloqueio se justifica sobretudo para conteúdos pagos.
Fontes
- Cloudflare, Content Independence Day: opções Search, Agent e Training (1º de julho de 2026, atualizado em 15 de julho)
- Google Search Central, rastreadores comuns do Google e token Google-Extended
- Cloudflare, relatório sobre os bots e a internet agêntica (1º de julho de 2026)
- Cloudflare, “Making AI search smarter”, do Pay Per Crawl ao Pay Per Use (1º de julho de 2026)
- Google, novo controle dos recursos de IA generativa no Search Console (3 de junho de 2026, atualizado em 31 de agosto de 2026)
- Google Search Central, registro de atualizações da documentação (entrada de 15 de junho de 2026 sobre llms.txt)