Robots.txt e addestramento delle IA: cosa cambia con il token comune di ottobre 2026
 Di Thierry Gustin
Aggiornato il
7 min di lettura

Indice
- Cosa dice esattamente il nuovo token del robots.txt?
- Addestramento, grounding, visualizzazione: di cosa parliamo?
- Cosa fanno Google, Microsoft e OpenAI?
- Quale robots.txt scrivere per rifiutare l'addestramento?
- Qual è il calendario del supporto?
- Cosa ne penso
- Cosa fare in concreto?
- Domande frequenti
- Fonti
La questione «robots.txt addestramento IA» ha ricevuto una risposta comune il 30 ottobre 2026: Google, Microsoft Bing e OpenAI hanno annunciato che rispetteranno una stessa riga, User-Agent: __usage_ai-training, per capire se un sito rifiuta che i suoi contenuti servano ad addestrare modelli[1][2][4]. Non è un blocco dei crawler: è una preferenza d'uso, che non toglie il tuo sito né da Google né da Bing. Il supporto arriverà per gradi, da febbraio 2027 su Bing e nel 2027 su Google.
Per una PMI la posta in gioco è facile da sottovalutare. Negli ultimi due anni molti siti hanno bloccato «i bot IA» in blocco, a volte a costo di sparire dalle risposte degli assistenti. Questo token permette finalmente di dire no all'addestramento senza dire no alle citazioni. Bisogna però sapere cosa copre e, soprattutto, cosa non copre.
Cosa dice esattamente il nuovo token del robots.txt?
Il testo di riferimento è una bozza depositata all'IETF il 30 ottobre 2026 da Kevin Kelley, di Anthropic[3]. È una proposta individuale: la pagina dell'IETF precisa che non è approvata dall'organismo e non ha alcuno status formale. Scade il 3 maggio 2027, salvo nuova versione.
Il principio si riassume in tre regole. Un gruppo User-Agent: __usage_ai-training esprime una preferenza su un uso, l'addestramento delle IA: Disallow significa «contrario», Allow significa «favorevole», con la stessa logica dei percorsi dello standard robots.txt (RFC 9309). La bozza sottolinea che questo token «non è una direttiva di crawling». Infine, un gruppo User-Agent: * non va interpretato come se lo coprisse: senza un gruppo esplicito, non esprimi alcuna preferenza[3].
Addestramento, grounding, visualizzazione: di cosa parliamo?
È la distinzione che faccio ripetere a tutti i miei clienti, perché questi tre usi ora si regolano separatamente. L'addestramento modifica il modello stesso: i tuoi testi alimentano le sue conoscenze, senza link né credito. Il grounding è l'IA che va a leggere delle pagine nel momento in cui risponde, e che può citarle. La visualizzazione in Google, infine, riguarda le AI Overview e la Modalità AI.
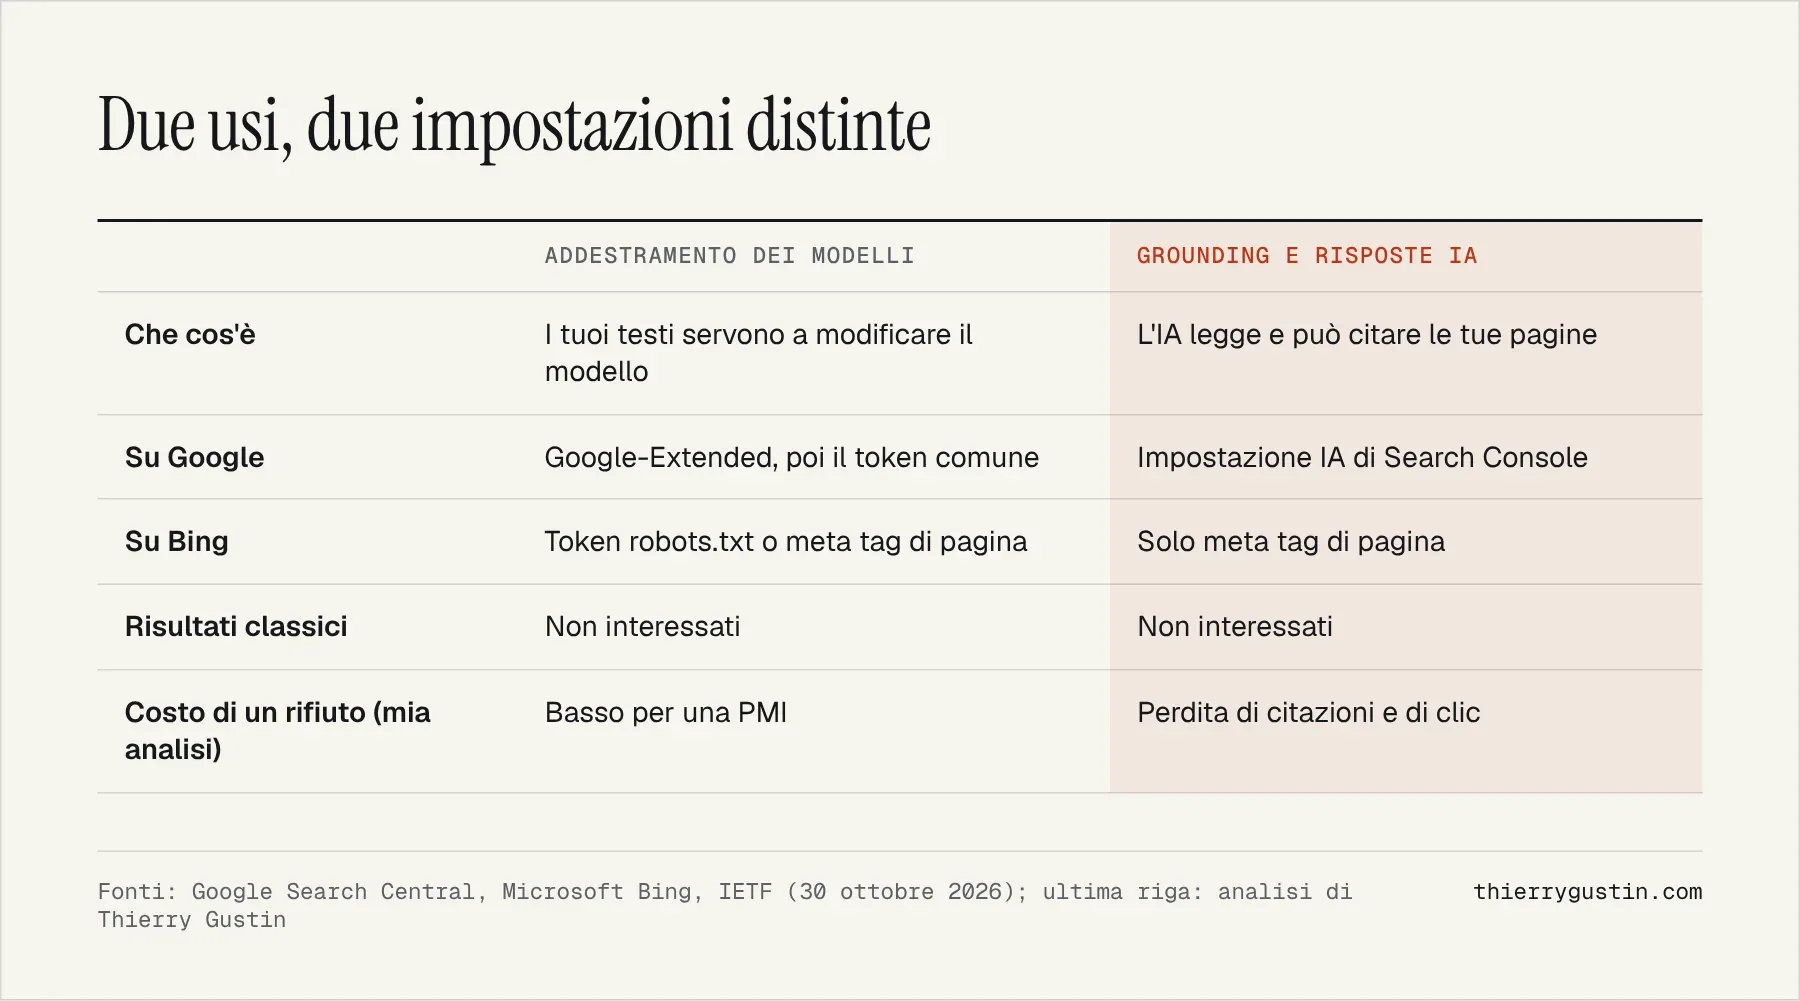
Su Google le due impostazioni sono ben separate. Il controllo «Search generative AI» di Search Console, aperto a tutti i siti il 31 agosto 2026, toglie i tuoi contenuti dalle AI Overview, dalla Modalità AI e dalle funzioni IA di Discover, ma la pagina di assistenza precisa che non impedisce l'addestramento, che dipende da Google-Extended[6]. Ho descritto questo pulsante e la griglia decisionale nel mio articolo sulla disattivazione delle AI Overview. Da parte sua, Google-Extended «non ha alcun impatto sull'inclusione di un sito in Google Search» e non è un segnale di ranking[5].
Cosa fanno Google, Microsoft e OpenAI?
Nel suo post del 30 ottobre, John Mueller annuncia che Google supporterà questo token condiviso con altri fornitori di IA «nel 2027»; la documentazione sui crawler di Google parla di «inizio 2027»[1][5]. Un dettaglio conta molto: se rifiuti l'addestramento con il token senza menzionare Google-Extended, Google lo interpreterà come un Disallow di Google-Extended[1].
Ma Google-Extended non copre solo l'addestramento. Copre anche il grounding nelle app Gemini, e Google ricorda che i siti che autorizzano Google-Extended possono comparire nelle risposte e ricevere clic[1][5]. Secondo la mia lettura, rifiutare l'addestramento con il token comune significa quindi, su Google, rinunciare anche a queste citazioni in Gemini. Il post non dice nulla, invece, sulle AI Overview né sul ranking.
Microsoft va oltre e separa nettamente due preferenze[2]. L'addestramento si regola tramite robots.txt, con lo stesso token, oppure pagina per pagina. Il grounding si regola solo pagina per pagina, con il tag <meta name="Bingbot" content="ai-grounding:disallow"> o l'intestazione X-Robots-Tag. Un terzo valore, ai-grounding:disallowextended, limita il grounding ai servizi gestiti da Microsoft, come Copilot, ed esclude i servizi di grounding forniti a terzi.
I tag NoArchive e NoCache, che alcuni usavano come rifiuto implicito, vengono sostituiti. Se il tuo sito li usa al 15 dicembre 2026, Bing propone una preferenza temporanea di grounding in Bing Webmaster Tools, da registrare entro il 1° marzo 2027; in caso contrario, queste pagine tornano per impostazione predefinita su «Allow» per il grounding fino al successivo passaggio del crawler[2].
Lo stesso giorno OpenAI si è impegnata a rispettare «un segnale robots.txt condiviso»[4]. Il riassunto ufficiale di questo annuncio, l'unica parte che ho potuto leggere, non indica una data di supporto. Quanto ad Anthropic, un cui dipendente firma la bozza, non è stato confermato alcun calendario.
Quale robots.txt scrivere per rifiutare l'addestramento?
Ecco il modello che propongo a una PMI che vuole rifiutare l'addestramento lasciando disponibile la sua pagina stampa, senza toccare i crawler dei motori di ricerca. Riprende solo la sintassi descritta dalla bozza IETF e da Bing[2][3]. Le tre righe di codice vanno una dopo l'altra, in quest'ordine, nel tuo file robots.txt.
User-Agent: __usage_ai-training: apre il gruppo del token comune. Si scrive così com'è (può variare solo l'uso di maiuscole e minuscole); un gruppoUser-Agent: *non lo copre.Disallow: /: preferenza contraria all'addestramento, per tutto il sito.Allow: /presse/: facoltativa. Preferenza favorevole solo per questa directory, secondo la regola della corrispondenza più lunga della RFC 9309. Sostituisci il percorso con il tuo, oppure elimina la riga.- I tuoi gruppi esistenti (
User-Agent: *,Googlebot,Bingbot…): non modificarli. La bozza precisa che le regole di crawling e le preferenze d'uso sono indipendenti.
Due precauzioni. Se vuoi mantenere il controllo su Gemini, su Google, conserva una regola esplicita per Google-Extended: secondo il post di Google, l'interpretazione predefinita si applica solo quando Google-Extended non è menzionato[1]. E per il grounding su Bing il robots.txt non serve a nulla: contano solo i meta tag di pagina e l'intestazione HTTP[2].
Qual è il calendario del supporto?
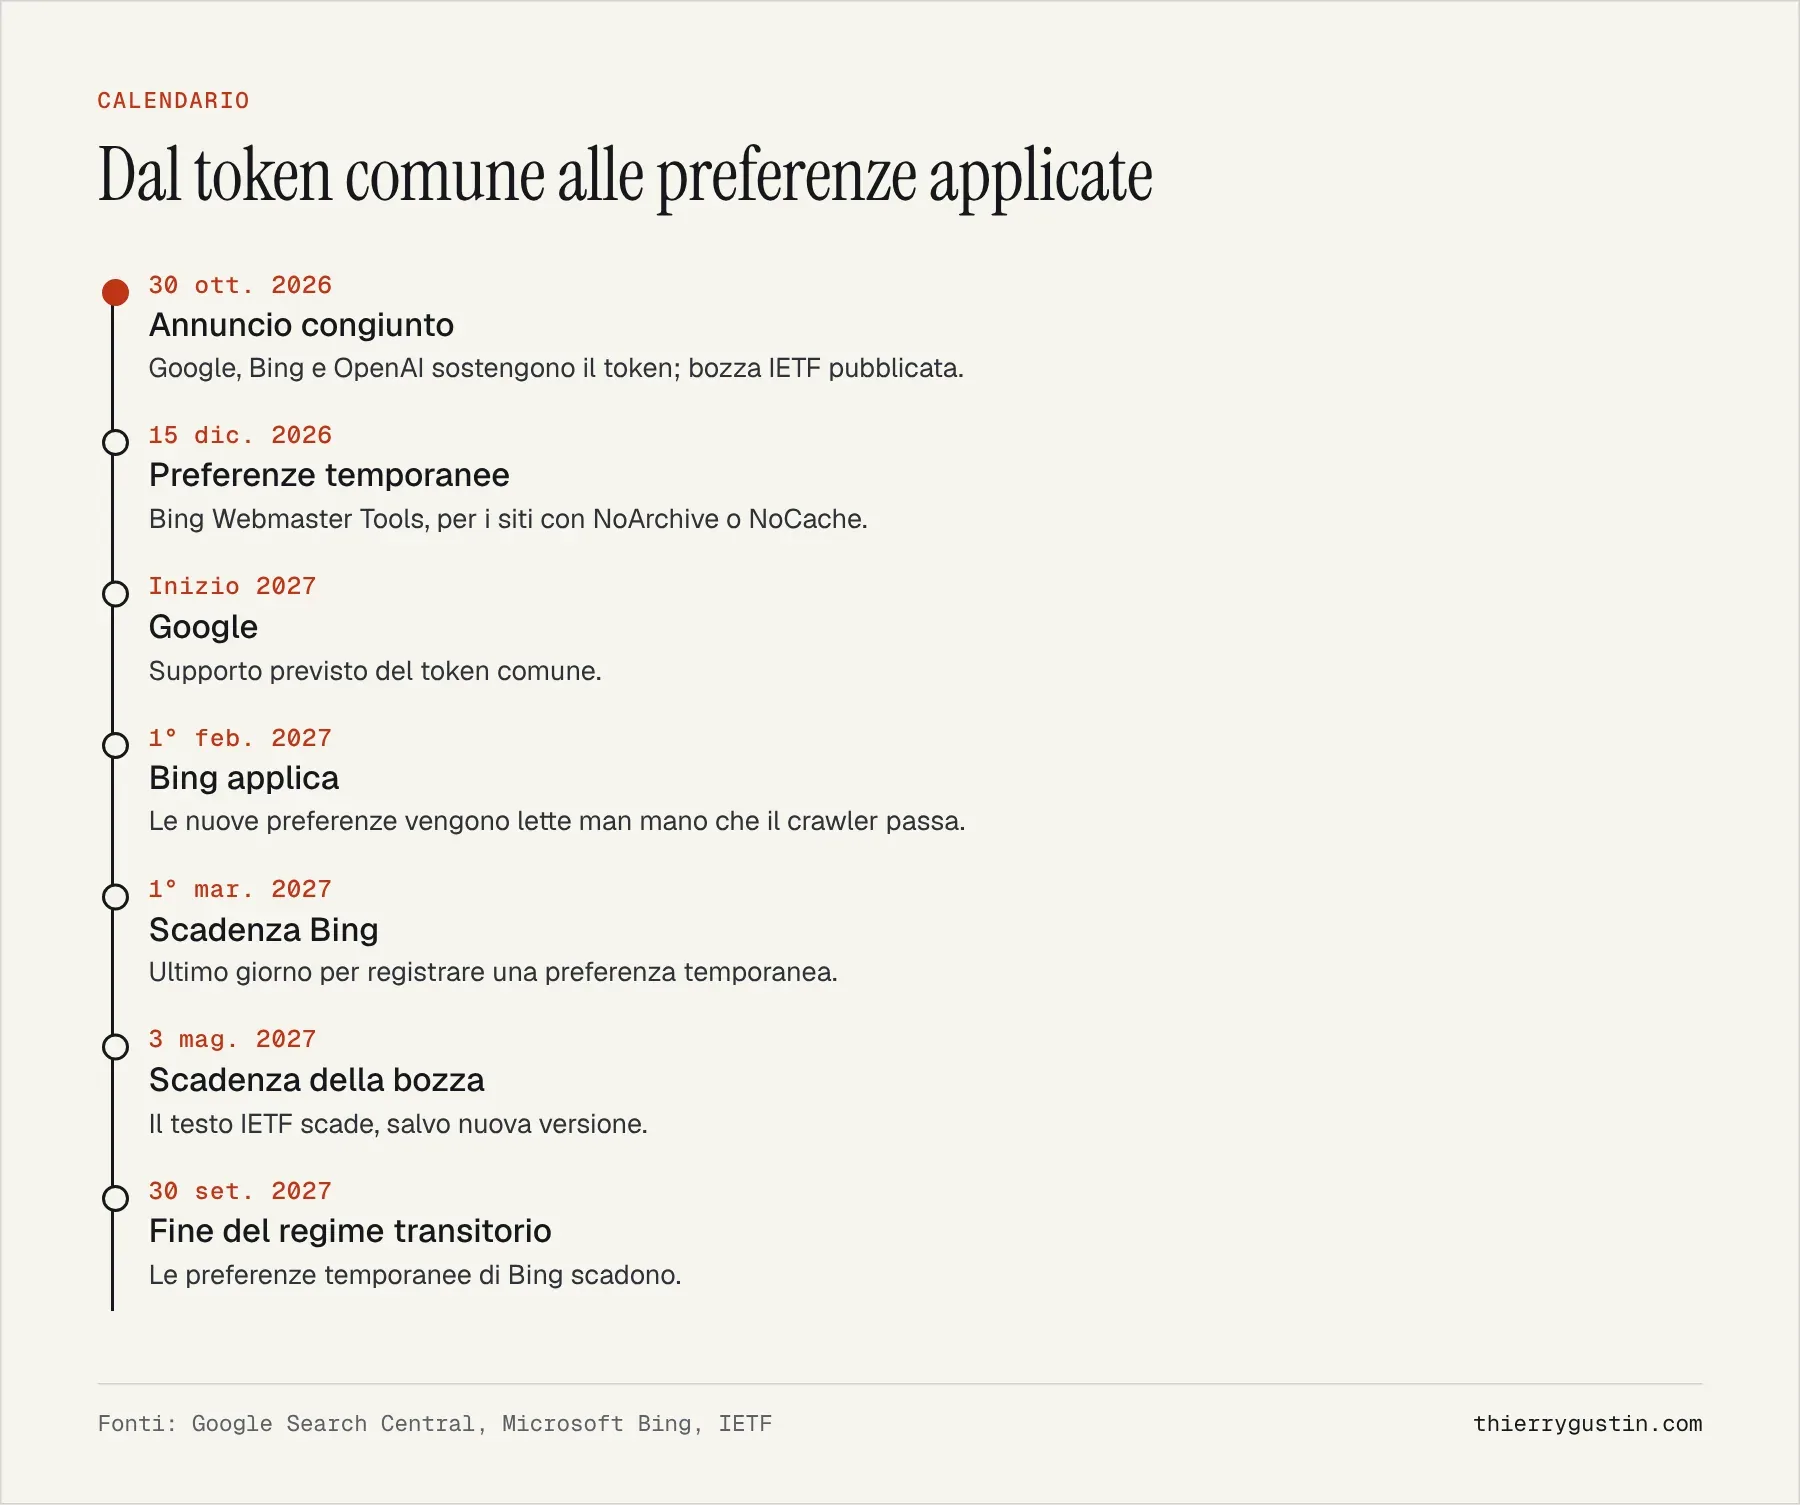
Aggiungere la riga oggi, quindi, non ha ancora un effetto garantito da nessuna parte. È il momento giusto per decidere con calma, invece di subire a marzo 2027 un'impostazione predefinita.
Cosa ne penso
È una buona notizia, con due riserve. La buona notizia: per la prima volta tre attori principali si allineano su una stessa riga, e si può dire «niente addestramento» senza bloccare crawler da cui dipende la propria visibilità. È l'errore che incontro più spesso negli audit: un robots.txt che blocca tutto ciò che somiglia a un'IA, copiato da un forum.
Prima riserva: è una preferenza, non una protezione. Lo dice la bozza stessa, non è una direttiva di crawling, e accordi privati possono prevalere su di essa[3]. Seconda riserva: su Google, l'addestramento e le citazioni in Gemini restano legati sotto Google-Extended. Rifiutare l'uno significa rinunciare all'altro, il che non è poco ora che gli assistenti diventano una porta d'ingresso.
Il mio consiglio predefinito per una PMI che vende servizi o prodotti: non rifiutare nulla. Le tue pagine commerciali hanno poco da perdere a essere apprese da un modello, e molto da guadagnare a essere conosciute da lui. Il rifiuto ha senso quando il contenuto è il prodotto: corsi a pagamento, studi originali, basi documentali. In quel caso rifiuta l'addestramento, ma lascia aperto il grounding, pagina per pagina se necessario.
Cosa fare in concreto?
- Fai l'inventario del tuo robots.txt e dei tuoi tag: blocchi ereditati di bot IA,
NoArchive,NoCache, regole Google-Extended. - Decidi per tipo di contenuto: pagine commerciali, blog e contenuti premium non hanno lo stesso interesse a essere appresi o citati.
- Se rifiuti l'addestramento, aggiungi il gruppo
__usage_ai-traininge decidi in modo esplicito il caso di Google-Extended. - Se usi NoArchive o NoCache, registra una preferenza temporanea in Bing Webmaster Tools tra il 15 dicembre 2026 e il 1° marzo 2027.
- Controlla Search Console: l'impostazione di esclusione dalle funzioni IA non deve essere attivata per errore.
Domande frequenti
Il token __usage_ai-training impedisce ai crawler di visitare il mio sito?
No. La bozza IETF precisa che non è una direttiva di crawling: esprime una preferenza sull'uso dei tuoi contenuti per addestrare le IA. Per limitare il passaggio di un crawler serve sempre un gruppo con il suo nome, per esempio Googlebot o Bingbot, il che ha altre conseguenze sulla tua visibilità.
Rifiutare l'addestramento mi fa sparire dalle AI Overview di Google?
Il post di Google del 30 ottobre 2026 non parla né delle AI Overview né del ranking. La visualizzazione nelle AI Overview e nella Modalità AI si regola a parte, in Search Console. Google tratterà però il rifiuto come un rifiuto di Google-Extended, che copre anche le citazioni nell'app Gemini.
Basta un User-Agent: * con Disallow per rifiutare l'addestramento?
No, ed è una trappola. La bozza precisa che un gruppo User-Agent: * non va interpretato come se coprisse il token di addestramento. Bisogna scrivere un gruppo User-Agent: __usage_ai-training esplicito. Al contrario, un Disallow sotto l'asterisco blocca la scansione di tutti i crawler, motori di ricerca compresi.
Fonti
- Google Search Central, John Mueller, controllo dell'addestramento delle IA tramite un token comune (30 ottobre 2026)
- Microsoft Bing, «Your content, your choice: clearer preferences for training and grounding» (30 ottobre 2026)
- IETF, draft-kelley-aipref-training-preference-signal-00, Kevin Kelley (30 ottobre 2026)
- OpenAI, «Helping websites express AI training preferences» (30 ottobre 2026, annuncio letto tramite il feed ufficiale)
- Google, documentazione sui crawler comuni, sezione Google-Extended
- Guida di Search Console, controllo «Search generative AI»