Robots.txt e treinamento das IAs: o que muda com o token comum de outubro de 2026
 Por Thierry Gustin
Atualizado em
8 min de leitura

Índice
- O que diz exatamente o novo token do robots.txt?
- Treinamento, grounding, exibição: do que estamos falando?
- O que estão fazendo Google, Microsoft e OpenAI?
- Que robots.txt escrever para recusar o treinamento?
- Qual é o calendário de implementação?
- O que eu penso
- O que fazer na prática?
- Perguntas frequentes
- Fontes
A questão de robots.txt e treinamento de IA ganhou uma resposta comum em 30 de outubro de 2026: Google, Microsoft Bing e OpenAI anunciaram que vão respeitar uma mesma linha, User-Agent: __usage_ai-training, para saber se um site recusa que seus conteúdos sejam usados para treinar modelos[1][2][4]. Não é um bloqueio dos robôs: é uma preferência de uso, que não tira o seu site nem do Google nem do Bing. A adoção será escalonada, a partir de fevereiro de 2027 no Bing e ao longo de 2027 no Google.
Para uma PME, é uma mudança fácil de deixar passar. Muitos sites bloquearam “os robôs de IA” no atacado nos últimos dois anos, às vezes ao custo de sumir das respostas dos assistentes. Esse token finalmente permite dizer não ao treinamento sem dizer não às citações. Mas é preciso saber o que ele cobre e, principalmente, o que ele não cobre.
O que diz exatamente o novo token do robots.txt?
O texto de referência é um rascunho apresentado ao IETF em 30 de outubro de 2026 por Kevin Kelley, da Anthropic[3]. Trata-se de uma submissão individual: a página do IETF esclarece que ela não foi aprovada pelo órgão e não tem nenhum status formal. O rascunho expira em 3 de maio de 2027, salvo nova versão.
O princípio cabe em três regras. Um grupo User-Agent: __usage_ai-training expressa uma preferência sobre um uso, o treinamento de IAs: Disallow significa “contra” e Allow significa “a favor”, com a mesma lógica de caminhos do padrão robots.txt (RFC 9309). O rascunho insiste que esse token “não é uma diretiva de rastreamento”. Por fim, um grupo User-Agent: * não deve ser interpretado como se o cobrisse: sem um grupo explícito, você não expressa nenhuma preferência[3].
Treinamento, grounding, exibição: do que estamos falando?
É a distinção que repito para todos os meus clientes, porque esses três usos agora são configurados separadamente. O treinamento modifica o próprio modelo: seus textos alimentam o conhecimento dele, sem link nem crédito. O grounding é a IA que vai ler páginas no momento de responder e que pode citá-las. Já a exibição no Google são os AI Overviews e o Modo IA.
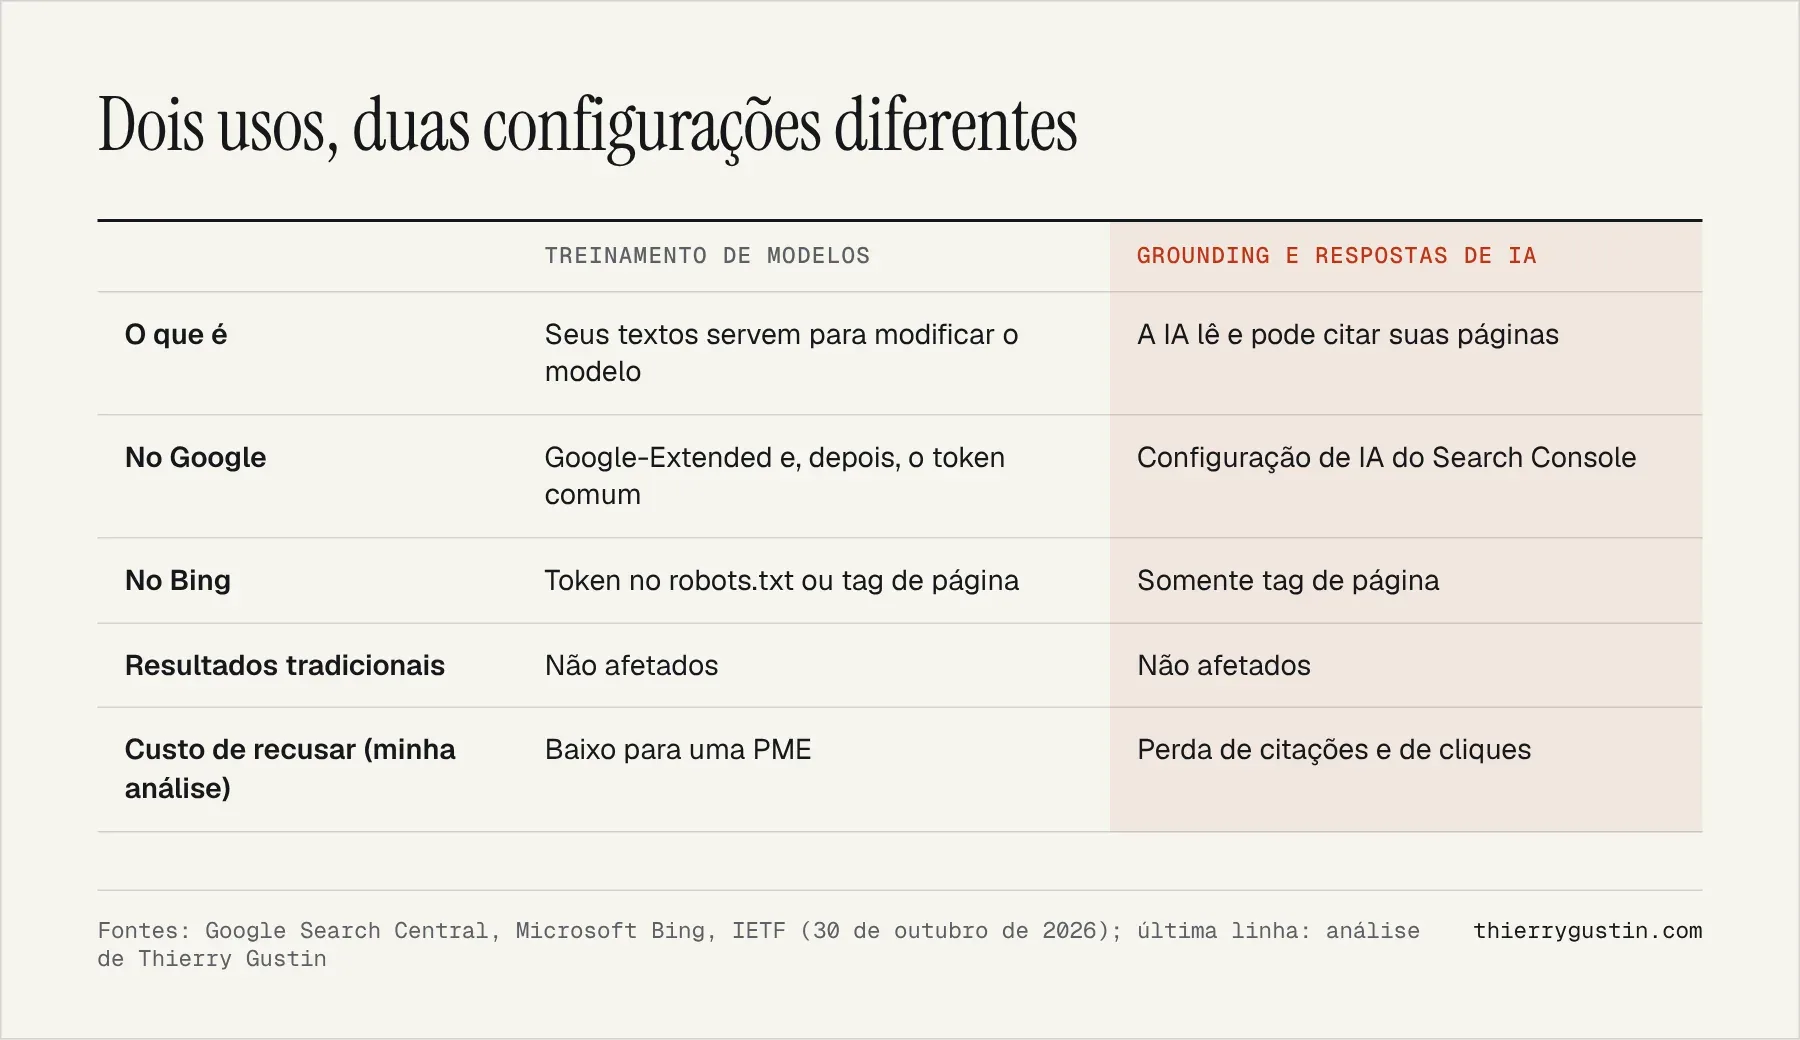
No Google, as duas configurações são bem separadas. O controle “Search generative AI” do Search Console, liberado para todos os sites em 31 de agosto de 2026, retira o seu conteúdo dos AI Overviews, do Modo IA e dos recursos de IA do Discover, mas a página de ajuda esclarece que ele não impede o treinamento, que depende do Google-Extended[6]. Detalhei esse botão e a grade de decisão no meu artigo sobre como desativar os AI Overviews. Já o Google-Extended “não afeta a inclusão de um site na Pesquisa Google” e não é um sinal de ranqueamento[5].
O que estão fazendo Google, Microsoft e OpenAI?
No post de 30 de outubro, John Mueller anuncia que o Google vai oferecer suporte a esse token, compartilhado com outros provedores de IA, “em 2027”; a documentação dos rastreadores do Google fala em “início de 2027”[1][5]. Um detalhe pesa muito: se você recusar o treinamento com o token sem mencionar o Google-Extended, o Google vai interpretar isso como um Disallow do Google-Extended[1].
Acontece que o Google-Extended não cobre apenas o treinamento. Ele também cobre o grounding nos apps do Gemini, e o Google lembra que os sites que permitem o Google-Extended podem aparecer nas respostas e receber cliques[1][5]. Na minha leitura, recusar o treinamento com o token comum significa, no Google, abrir mão também dessas citações no Gemini. Por outro lado, o post não diz nada sobre os AI Overviews nem sobre o ranqueamento.
A Microsoft vai além e separa claramente duas preferências[2]. O treinamento é configurado no robots.txt, com o mesmo token, ou por página. O grounding só é configurado página por página, com a tag <meta name="Bingbot" content="ai-grounding:disallow"> ou o cabeçalho X-Robots-Tag. Um terceiro valor, ai-grounding:disallowextended, limita o grounding aos serviços operados pela Microsoft, como o Copilot, e exclui os serviços de grounding fornecidos a terceiros.
As tags NoArchive e NoCache, que alguns usavam como recusa implícita, foram substituídas. Se o seu site ainda as utilizar em 15 de dezembro de 2026, o Bing oferece uma preferência temporária de grounding no Bing Webmaster Tools, que deve ser registrada antes de 1º de março de 2027; sem isso, essas páginas voltam por padrão para “Allow” no grounding até a próxima passagem do robô[2].
A OpenAI se comprometeu no mesmo dia a respeitar “um sinal de robots.txt compartilhado”[4]. O resumo oficial desse anúncio, a única parte que consegui ler, não traz data de implementação. Quanto à Anthropic, que tem um funcionário assinando o rascunho, nenhum calendário foi confirmado.
Que robots.txt escrever para recusar o treinamento?
Este é o modelo que proponho a uma PME que quer recusar o treinamento mantendo a sua página de imprensa disponível, sem mexer nos robôs de busca. Ele usa apenas a sintaxe descrita pelo rascunho do IETF e pelo Bing[2][3]. As três linhas de código ficam em sequência, nesta ordem, no seu arquivo robots.txt.
User-Agent: __usage_ai-training: abre o grupo do token comum. Ele é escrito exatamente assim (só a caixa das letras pode variar); um grupoUser-Agent: *não o cobre.Disallow: /: preferência contra o treinamento, para o site inteiro.Allow: /presse/: opcional. Preferência favorável apenas para esse diretório, segundo a regra da correspondência mais longa da RFC 9309. Troque o caminho pelo seu (por exemplo, o da sua sala de imprensa) ou apague a linha.- Seus grupos atuais (
User-Agent: *,Googlebot,Bingbot…): não os altere. O rascunho esclarece que as regras de rastreamento e as preferências de uso são independentes.
Dois cuidados. Se você quer manter o controle sobre o Gemini no Google, conserve uma regra explícita para o Google-Extended: segundo o post do Google, a interpretação padrão só vale quando o Google-Extended não é mencionado[1]. E, para o grounding no Bing, o robots.txt não serve para nada: só contam as tags de página e o cabeçalho HTTP[2].
Qual é o calendário de implementação?
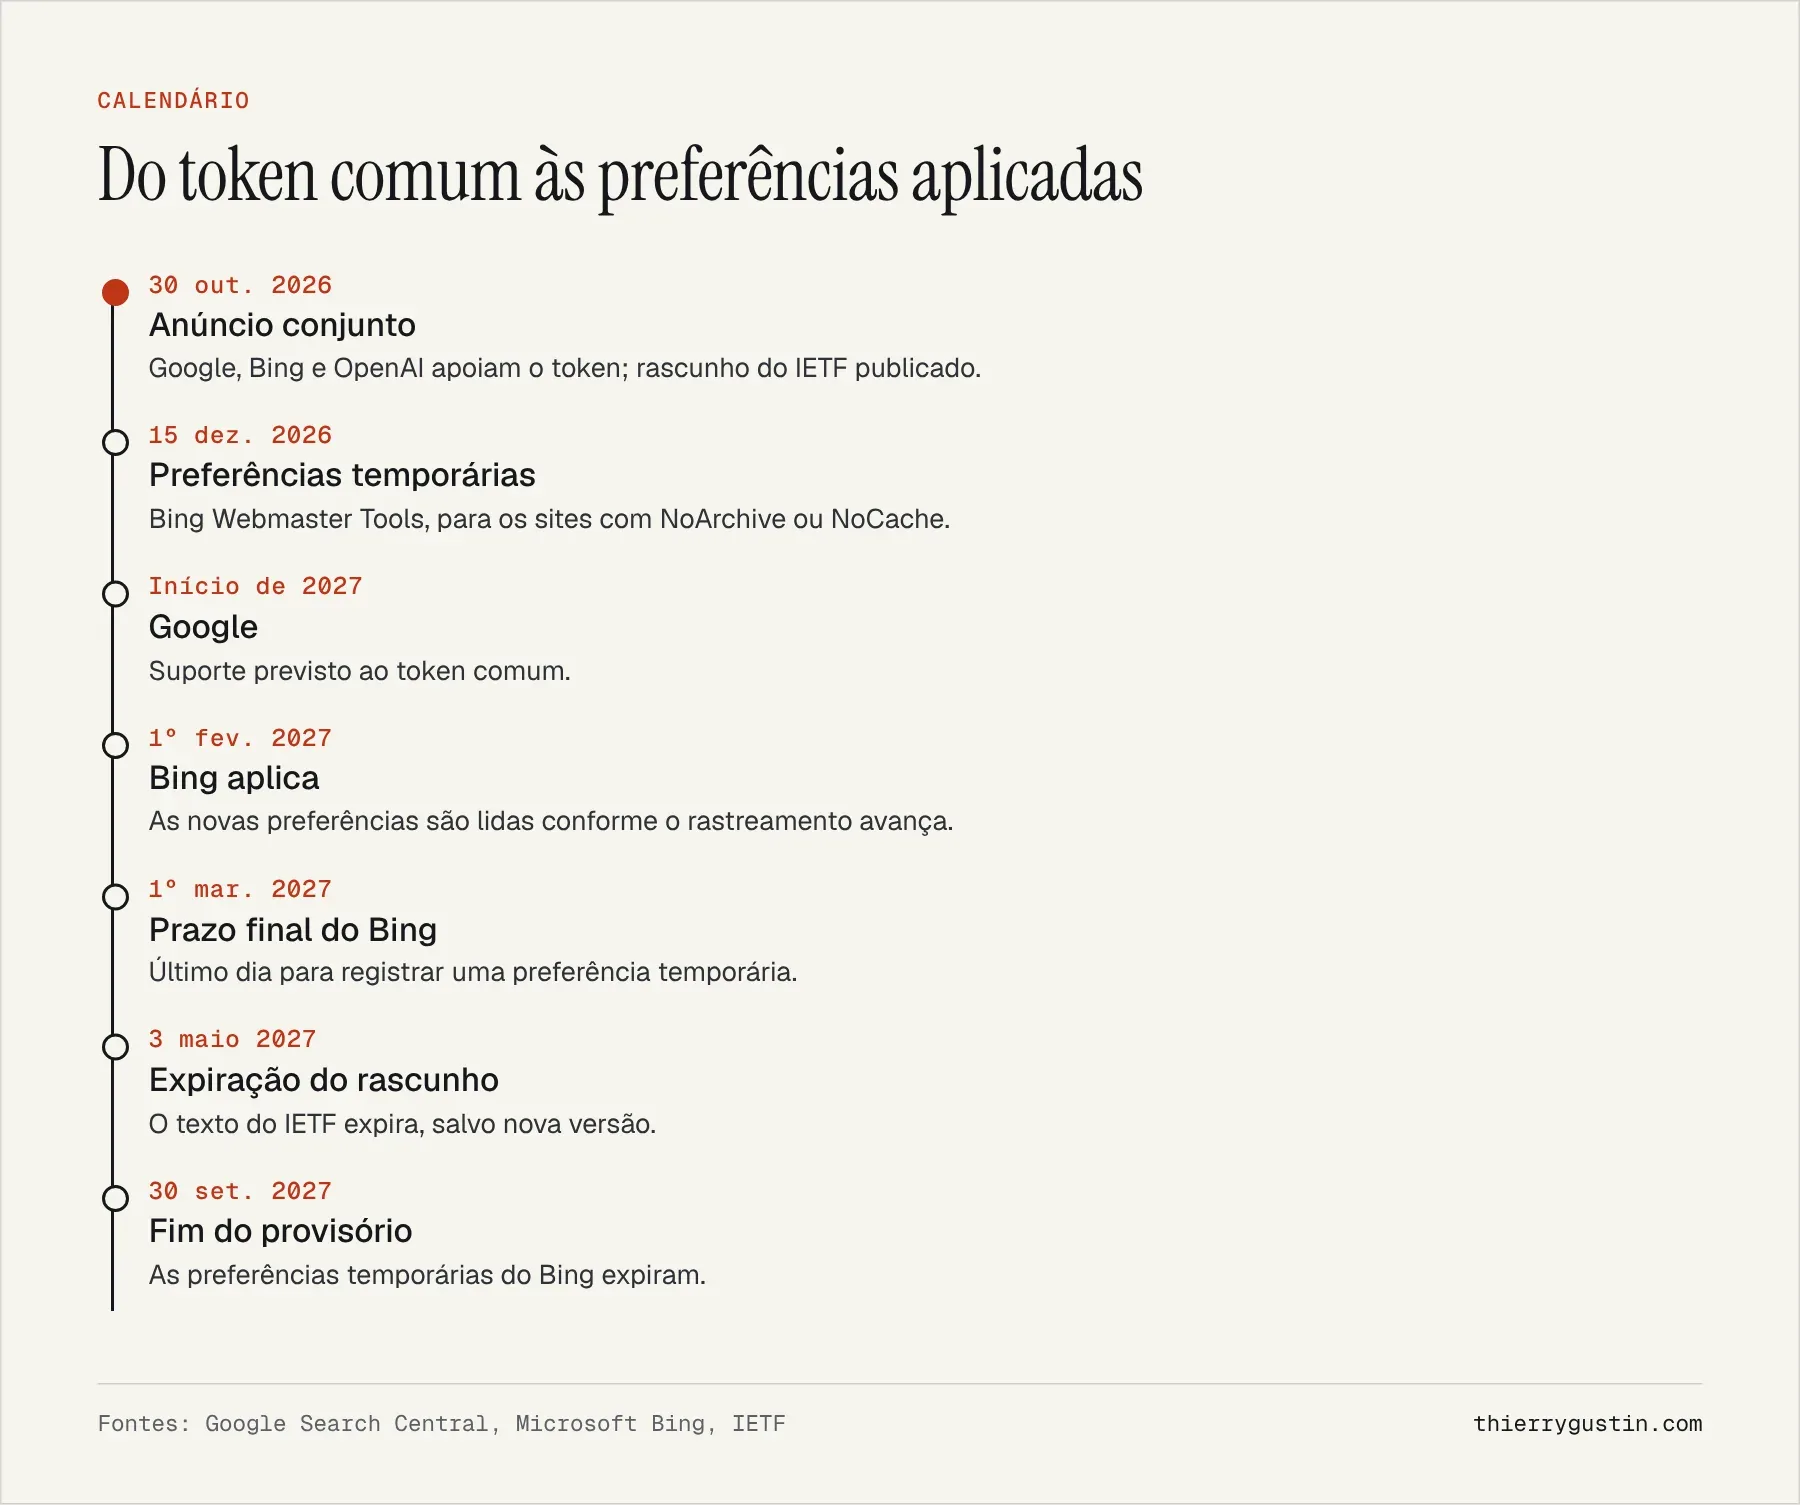
Ou seja, adicionar a linha hoje ainda não tem efeito garantido em lugar nenhum. É o momento certo para decidir com calma, em vez de ser pego em março de 2027 por uma configuração padrão.
O que eu penso
É uma boa notícia, com duas ressalvas. A boa notícia: pela primeira vez, três grandes empresas se alinham em uma mesma linha, e dá para dizer “sem treinamento” sem bloquear robôs dos quais depende a sua visibilidade. É o erro que mais encontro em auditorias: um robots.txt que bloqueia tudo o que parece IA, copiado de um fórum.
Primeira ressalva: é uma preferência, não uma proteção. O próprio rascunho diz que não se trata de uma diretiva de rastreamento, e acordos privados podem prevalecer sobre ela[3]. Segunda ressalva: no Google, o treinamento e as citações no Gemini continuam ligados sob o Google-Extended. Recusar um é abrir mão do outro, o que não é pouca coisa num momento em que os assistentes viram porta de entrada.
Meu conselho padrão para uma PME que vende serviços ou produtos: não recusar nada. Suas páginas comerciais têm pouco a perder ao serem aprendidas por um modelo, e muito a ganhar ao serem conhecidas por ele. A recusa faz sentido quando o conteúdo é o produto: cursos pagos, estudos originais, bases de documentação. Nesse caso, recuse o treinamento, mas deixe o grounding aberto, página por página se necessário.
O que fazer na prática?
- Faça o inventário do seu robots.txt e das suas tags: bloqueios herdados de robôs de IA,
NoArchive,NoCache, regras de Google-Extended. - Decida por tipo de conteúdo: páginas comerciais, blog e conteúdos premium não têm o mesmo interesse em ser aprendidos ou citados.
- Se você recusar o treinamento, adicione o grupo
__usage_ai-traininge defina explicitamente o que fazer com o Google-Extended. - Se você usa NoArchive ou NoCache, registre uma preferência temporária no Bing Webmaster Tools entre 15 de dezembro de 2026 e 1º de março de 2027.
- Confira o Search Console: a configuração de exclusão dos recursos de IA não deve estar ativada por engano.
Perguntas frequentes
O token __usage_ai-training impede os robôs de visitar meu site?
Não. O rascunho do IETF esclarece que não se trata de uma diretiva de rastreamento: ele expressa uma preferência sobre o uso dos seus conteúdos para treinar IAs. Para limitar a passagem de um robô, continua sendo necessário um grupo com o nome dele, por exemplo Googlebot ou Bingbot, o que tem outras consequências para a sua visibilidade.
Recusar o treinamento faz meu site sumir dos AI Overviews do Google?
O post do Google de 30 de outubro de 2026 não fala nem dos AI Overviews nem do ranqueamento. A exibição nos AI Overviews e no Modo IA é configurada separadamente, no Search Console. Por outro lado, o Google vai tratar a recusa como uma recusa do Google-Extended, que também cobre as citações no app Gemini.
Um User-Agent: * com Disallow basta para recusar o treinamento?
Não, e essa é uma armadilha. O rascunho esclarece que um grupo User-Agent: * não deve ser interpretado como se cobrisse o token de treinamento. É preciso escrever um grupo User-Agent: __usage_ai-training explícito. Pelo contrário, um Disallow sob o asterisco bloqueia o rastreamento de todos os robôs, inclusive dos mecanismos de busca.
Fontes
- Google Search Central, John Mueller, controle do treinamento de IAs por um token comum (30 de outubro de 2026)
- Microsoft Bing, “Your content, your choice: clearer preferences for training and grounding” (30 de outubro de 2026)
- IETF, draft-kelley-aipref-training-preference-signal-00, Kevin Kelley (30 de outubro de 2026)
- OpenAI, “Helping websites express AI training preferences” (30 de outubro de 2026, anúncio lido pelo feed oficial)
- Google, documentação dos rastreadores comuns, seção Google-Extended
- Ajuda do Search Console, controle “Search generative AI”