Robots.txt und KI-Training: Was das gemeinsame Token vom Oktober 2026 ändert
 Von Thierry Gustin
Aktualisiert am
7 Min. Lesezeit

Inhalt
- Was genau besagt das neue robots.txt-Token?
- Training, Grounding, Anzeige: Worum geht es eigentlich?
- Was machen Google, Microsoft und OpenAI?
- Welche robots.txt sollten Sie schreiben, um dem Training zu widersprechen?
- Wie sieht der Zeitplan für die Unterstützung aus?
- Meine Einschätzung
- Was ist konkret zu tun?
- Häufige Fragen
- Quellen
Die Frage „robots.txt KI-Training“ hat am 30. Oktober 2026 eine gemeinsame Antwort bekommen: Google, Microsoft Bing und OpenAI haben angekündigt, dieselbe Zeile zu respektieren, User-Agent: __usage_ai-training, um zu erkennen, ob eine Website nicht möchte, dass ihre Inhalte zum Training von Modellen verwendet werden[1][2][4]. Das ist keine Sperre für Crawler, sondern eine Nutzungspräferenz, die Ihre Website weder aus Google noch aus Bing entfernt. Die Unterstützung kommt gestaffelt: ab Februar 2027 bei Bing und im Laufe des Jahres 2027 bei Google.
Für kleine und mittlere Unternehmen ist die Tragweite leicht zu übersehen. Viele Websites haben in den letzten zwei Jahren „die KI-Bots“ pauschal ausgesperrt, manchmal um den Preis ihrer Präsenz in den Antworten der Assistenten. Mit diesem Token können Sie endlich Nein zum Training sagen, ohne Nein zu Zitaten zu sagen. Sie müssen allerdings wissen, was es abdeckt und vor allem, was es nicht abdeckt.
Was genau besagt das neue robots.txt-Token?
Der Referenztext ist ein Entwurf, den Kevin Kelley von Anthropic am 30. Oktober 2026 bei der IETF eingereicht hat[3]. Es handelt sich um eine Einzeleinreichung: Die IETF-Seite stellt klar, dass sie von der Organisation nicht gebilligt wurde und keinen formellen Status hat. Sie läuft am 3. Mai 2027 ab, sofern keine neue Version erscheint.
Das Prinzip lässt sich in drei Regeln fassen. Eine Gruppe User-Agent: __usage_ai-training drückt eine Präferenz zu einer bestimmten Nutzung aus, dem KI-Training: Disallow bedeutet „dagegen“, Allow bedeutet „dafür“, mit derselben Pfadlogik wie der robots.txt-Standard (RFC 9309). Der Entwurf betont, dass dieses Token „keine Crawling-Direktive“ ist. Und schließlich darf eine Gruppe User-Agent: * nicht so ausgelegt werden, als würde sie das Token einschließen: Ohne ausdrückliche Gruppe äußern Sie überhaupt keine Präferenz[3].
Training, Grounding, Anzeige: Worum geht es eigentlich?
Diese Unterscheidung lasse ich mir von allen meinen Kunden wiederholen, weil sich die drei Nutzungen inzwischen getrennt steuern lassen. Training verändert das Modell selbst: Ihre Texte fließen in sein Wissen ein, ohne Link und ohne Quellenangabe. Grounding bedeutet, dass die KI im Moment der Antwort Seiten liest und sie zitieren kann. Die Anzeige in Google schließlich, das sind die KI-Übersichten und der KI-Modus.
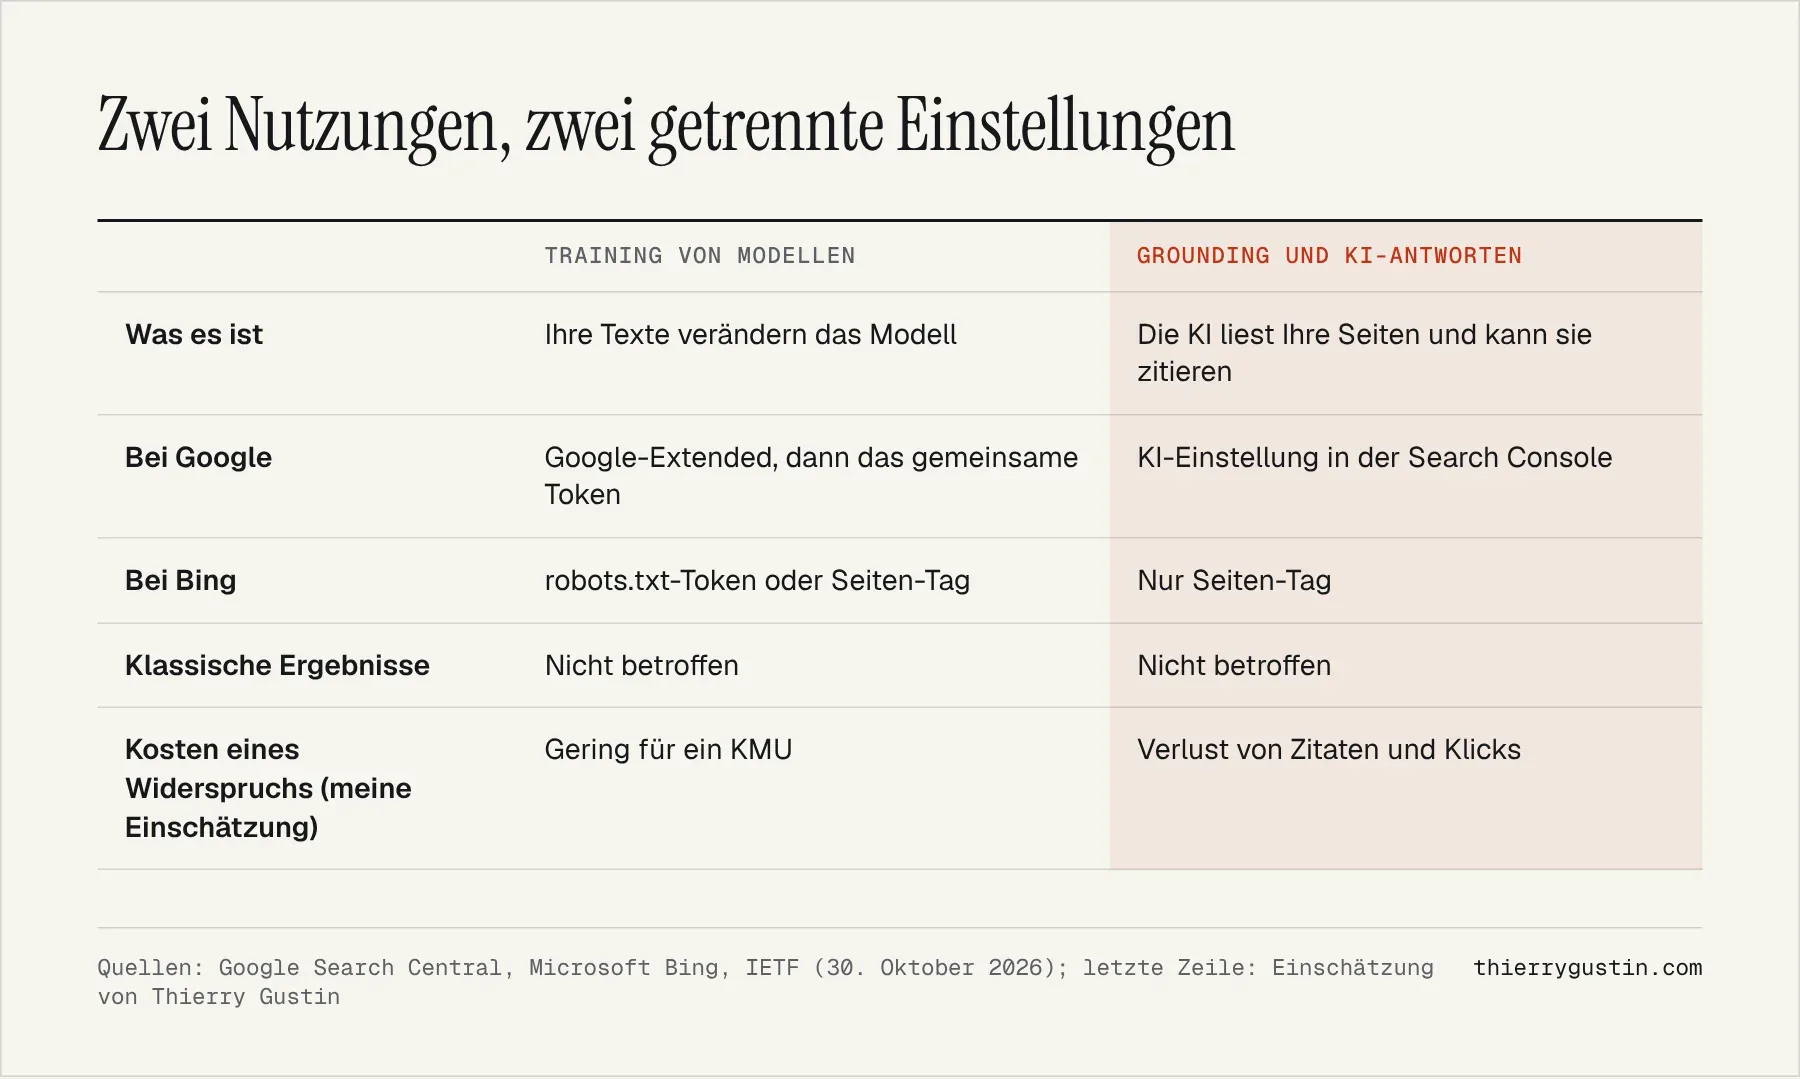
Bei Google sind beide Einstellungen klar getrennt. Die Steuerung „Search generative AI“ in der Search Console, die seit dem 31. August 2026 allen Websites offensteht, entfernt Ihre Inhalte aus den KI-Übersichten, dem KI-Modus und den KI-Funktionen von Discover. Die Hilfeseite stellt aber klar, dass sie das Training nicht verhindert, denn dafür ist Google-Extended zuständig[6]. Diese Einstellung und das Entscheidungsraster habe ich in meinem Artikel zum Deaktivieren der KI-Übersichten ausführlich beschrieben. Google-Extended wiederum hat „keinen Einfluss auf die Aufnahme einer Website in die Google Suche“ und ist kein Ranking-Signal[5].
Was machen Google, Microsoft und OpenAI?
In seinem Beitrag vom 30. Oktober kündigt John Mueller an, dass Google dieses mit anderen KI-Anbietern geteilte Token „2027“ unterstützen wird; die Crawler-Dokumentation von Google spricht von „Anfang 2027“[1][5]. Ein Detail ist dabei entscheidend: Wenn Sie dem Training mit dem Token widersprechen, ohne Google-Extended zu erwähnen, wertet Google das als Disallow für Google-Extended[1].
Google-Extended deckt aber nicht nur das Training ab. Es umfasst auch das Grounding in den Gemini-Apps, und Google weist darauf hin, dass Websites, die Google-Extended zulassen, dort in den Antworten erscheinen und Klicks erhalten können[1][5]. Nach meiner Lesart bedeutet ein Widerspruch gegen das Training mit dem gemeinsamen Token bei Google also auch den Verzicht auf diese Zitate in Gemini. Zu den KI-Übersichten und zum Ranking sagt der Beitrag dagegen nichts.
Microsoft geht weiter und trennt zwei Präferenzen klar voneinander[2]. Das Training wird über die robots.txt gesteuert, mit demselben Token, oder auf Seitenebene. Das Grounding lässt sich nur seitenweise steuern, mit dem Tag <meta name="Bingbot" content="ai-grounding:disallow"> oder dem Header X-Robots-Tag. Ein dritter Wert, ai-grounding:disallowextended, beschränkt das Grounding auf von Microsoft betriebene Dienste wie Copilot und schließt Grounding-Dienste für Dritte aus.
Die Tags NoArchive und NoCache, die manche als stillschweigenden Widerspruch genutzt haben, werden abgelöst. Wenn Ihre Website sie am 15. Dezember 2026 verwendet, bietet Bing in den Bing Webmaster Tools eine vorläufige Grounding-Präferenz an, die vor dem 1. März 2027 hinterlegt werden muss; andernfalls fallen diese Seiten beim Grounding standardmäßig auf „Allow“ zurück, bis der Crawler sie das nächste Mal besucht[2].
OpenAI hat sich am selben Tag verpflichtet, „ein gemeinsames robots.txt-Signal“ zu respektieren[4]. Die offizielle Zusammenfassung dieser Ankündigung, der einzige Teil, den ich lesen konnte, nennt kein Datum für die Unterstützung. Und für Anthropic, dessen Mitarbeiter den Entwurf verfasst hat, wurde noch kein Zeitplan bestätigt.
Welche robots.txt sollten Sie schreiben, um dem Training zu widersprechen?
Hier ist die Vorlage, die ich einem KMU vorschlage, das dem Training widersprechen, seinen Pressebereich aber freigeben möchte, ohne seine Such-Crawler anzutasten. Sie verwendet ausschließlich die Syntax, die der IETF-Entwurf und Bing beschreiben[2][3]. Die drei Codezeilen stehen in Ihrer robots.txt-Datei direkt untereinander, in genau dieser Reihenfolge.
User-Agent: __usage_ai-training: eröffnet die Gruppe des gemeinsamen Tokens. Es wird genau so geschrieben (nur die Groß- und Kleinschreibung darf abweichen); eine GruppeUser-Agent: *deckt es nicht ab.Disallow: /: Präferenz gegen das Training, für die gesamte Website.Allow: /presse/: optional. Zustimmende Präferenz nur für dieses Verzeichnis, nach der Regel der längsten Übereinstimmung aus RFC 9309. Ersetzen Sie den Pfad durch Ihren eigenen oder löschen Sie die Zeile.- Ihre bestehenden Gruppen (
User-Agent: *,Googlebot,Bingbot…): Ändern Sie sie nicht. Laut Entwurf sind Crawling-Regeln und Nutzungspräferenzen voneinander unabhängig.
Zwei Vorsichtsmaßnahmen. Wenn Sie bei Google die Kontrolle über Gemini behalten wollen, behalten Sie eine ausdrückliche Regel für Google-Extended bei: Laut dem Google-Beitrag greift die Standardauslegung nur, wenn Google-Extended nicht erwähnt wird[1]. Und für das Grounding bei Bing nützt die robots.txt nichts: Dort zählen nur die Seiten-Tags und der HTTP-Header[2].
Wie sieht der Zeitplan für die Unterstützung aus?
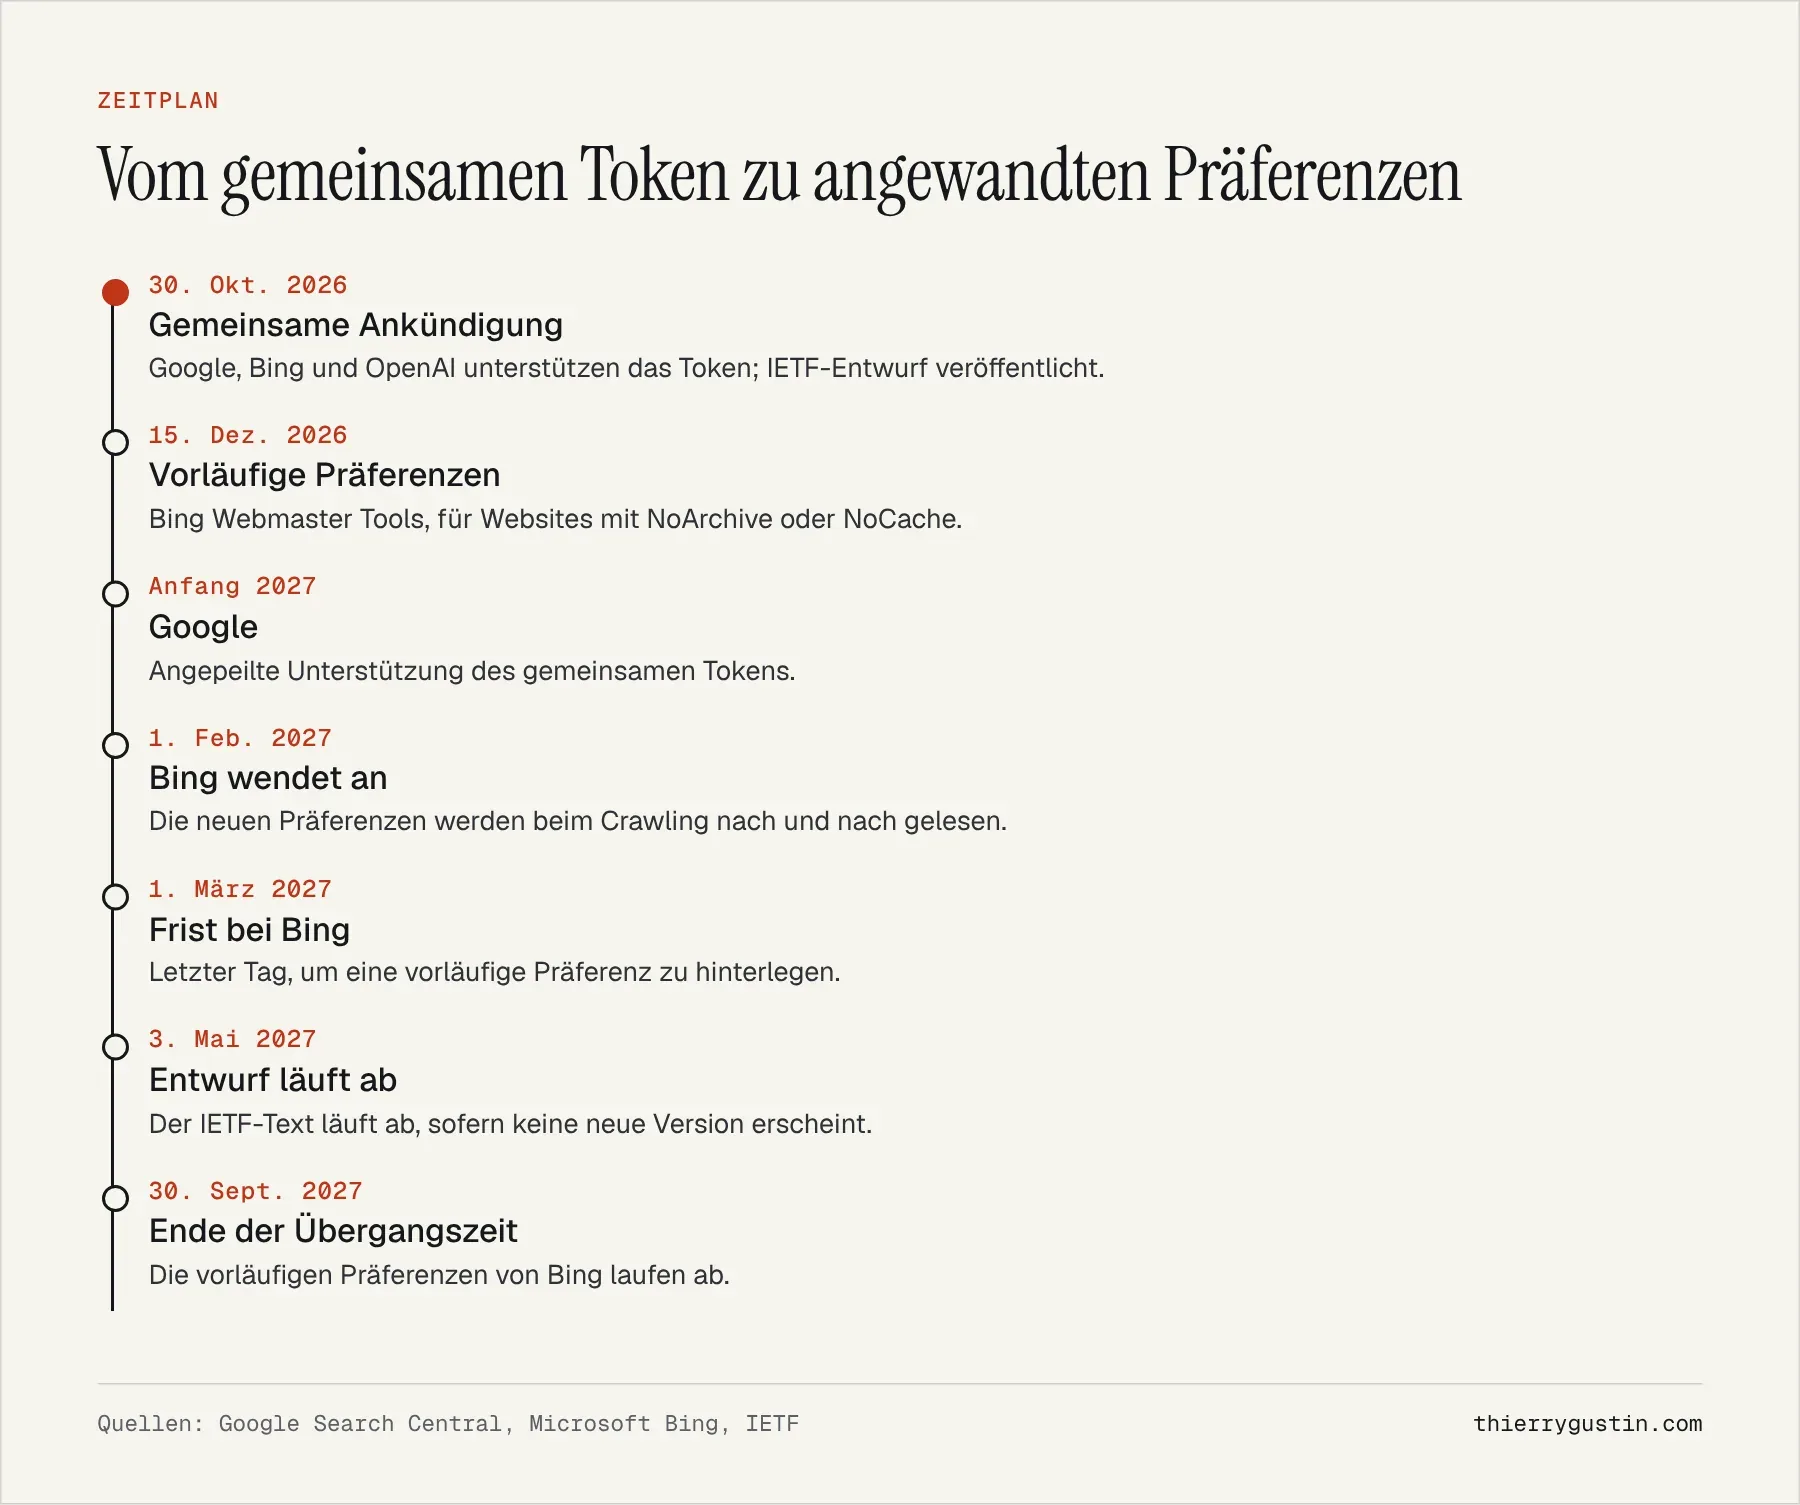
Wer die Zeile heute hinzufügt, erzielt also noch nirgends eine garantierte Wirkung. Gerade deshalb ist jetzt der richtige Moment, in Ruhe zu entscheiden, statt im März 2027 eine Standardeinstellung hinnehmen zu müssen.
Meine Einschätzung
Das ist eine gute Nachricht, mit zwei Einschränkungen. Die gute Nachricht: Zum ersten Mal einigen sich drei große Akteure auf eine einzige Zeile, und man kann „kein Training“ sagen, ohne Crawler auszusperren, von denen die eigene Sichtbarkeit abhängt. Das ist der Fehler, dem ich in Audits am häufigsten begegne: eine robots.txt, die alles blockiert, was nach KI aussieht, abgeschrieben aus einem Forum.
Erste Einschränkung: Es ist eine Präferenz, kein Schutz. Der Entwurf sagt es selbst, es handelt sich nicht um eine Crawling-Direktive, und private Vereinbarungen können Vorrang haben[3]. Zweite Einschränkung: Bei Google bleiben Training und Zitate in Gemini unter Google-Extended miteinander verknüpft. Wer das eine ablehnt, verzichtet auf das andere, und das ist keine Kleinigkeit in einer Zeit, in der Assistenten zum Eingangstor werden.
Mein Standardrat für ein KMU, das Dienstleistungen oder Produkte verkauft: nichts ablehnen. Ihre kommerziellen Seiten haben wenig zu verlieren, wenn ein Modell sie lernt, und viel zu gewinnen, wenn es sie kennt. Ein Widerspruch ist sinnvoll, wenn der Inhalt selbst das Produkt ist: kostenpflichtige Kurse, eigene Studien, Dokumentendatenbanken. In diesem Fall widersprechen Sie dem Training, lassen das Grounding aber offen, notfalls Seite für Seite.
Was ist konkret zu tun?
- Machen Sie eine Bestandsaufnahme Ihrer robots.txt und Ihrer Tags: übernommene Sperren für KI-Bots,
NoArchive,NoCache, Regeln für Google-Extended. - Entscheiden Sie nach Inhaltstyp: Verkaufsseiten, Blog und Premium-Inhalte haben nicht dasselbe Interesse daran, gelernt oder zitiert zu werden.
- Wenn Sie dem Training widersprechen, fügen Sie die Gruppe
__usage_ai-traininghinzu und regeln Sie den Fall Google-Extended ausdrücklich. - Wenn Sie NoArchive oder NoCache verwenden, hinterlegen Sie zwischen dem 15. Dezember 2026 und dem 1. März 2027 eine vorläufige Präferenz in den Bing Webmaster Tools.
- Prüfen Sie die Search Console: Die Einstellung zum Ausschluss aus den KI-Funktionen darf nicht versehentlich aktiviert sein.
Häufige Fragen
Hindert das Token __usage_ai-training Bots daran, meine Website zu besuchen?
Nein. Der IETF-Entwurf stellt klar, dass es keine Crawling-Direktive ist: Es drückt eine Präferenz zur Nutzung Ihrer Inhalte für das Training von KI aus. Um die Besuche eines Crawlers einzuschränken, brauchen Sie weiterhin eine Gruppe mit seinem Namen, etwa Googlebot oder Bingbot, was andere Folgen für Ihre Sichtbarkeit hat.
Verschwinde ich aus den KI-Übersichten von Google, wenn ich dem KI-Training widerspreche?
Der Google-Beitrag vom 30. Oktober 2026 erwähnt weder die KI-Übersichten noch das Ranking. Die Anzeige in den KI-Übersichten und im KI-Modus wird getrennt in der Search Console gesteuert. Google wird den Widerspruch allerdings als Widerspruch gegen Google-Extended behandeln, und das umfasst auch die Zitate in der Gemini-App.
Reicht User-Agent: * mit Disallow, um dem KI-Training zu widersprechen?
Nein, und das ist eine Falle. Laut Entwurf darf eine Gruppe User-Agent: * nicht so ausgelegt werden, als würde sie das Trainings-Token abdecken. Sie müssen eine ausdrückliche Gruppe User-Agent: __usage_ai-training schreiben. Umgekehrt sperrt ein Disallow unter dem Sternchen das Crawling durch alle Bots, Suchmaschinen eingeschlossen.
Quellen
- Google Search Central, John Mueller, Steuerung des KI-Trainings über ein gemeinsames Token (30. Oktober 2026)
- Microsoft Bing, „Your content, your choice: clearer preferences for training and grounding“ (30. Oktober 2026)
- IETF, draft-kelley-aipref-training-preference-signal-00, Kevin Kelley (30. Oktober 2026)
- OpenAI, „Helping websites express AI training preferences“ (30. Oktober 2026, Ankündigung über den offiziellen Feed gelesen)
- Google, Dokumentation der gängigen Crawler, Abschnitt Google-Extended
- Search Console-Hilfe, Steuerung „Search generative AI“